LatentPort: 하이브리드 LLM의 재귀 메모리 모델 간 전송 연구
LatentPort: Beyond KV Cache - Cross-Model Transfer of Recurrent Memory in Hybrid Language Models: A 4B-to-9B Hybrid-State Handoff Without Target Prefix Replay
 arXiv
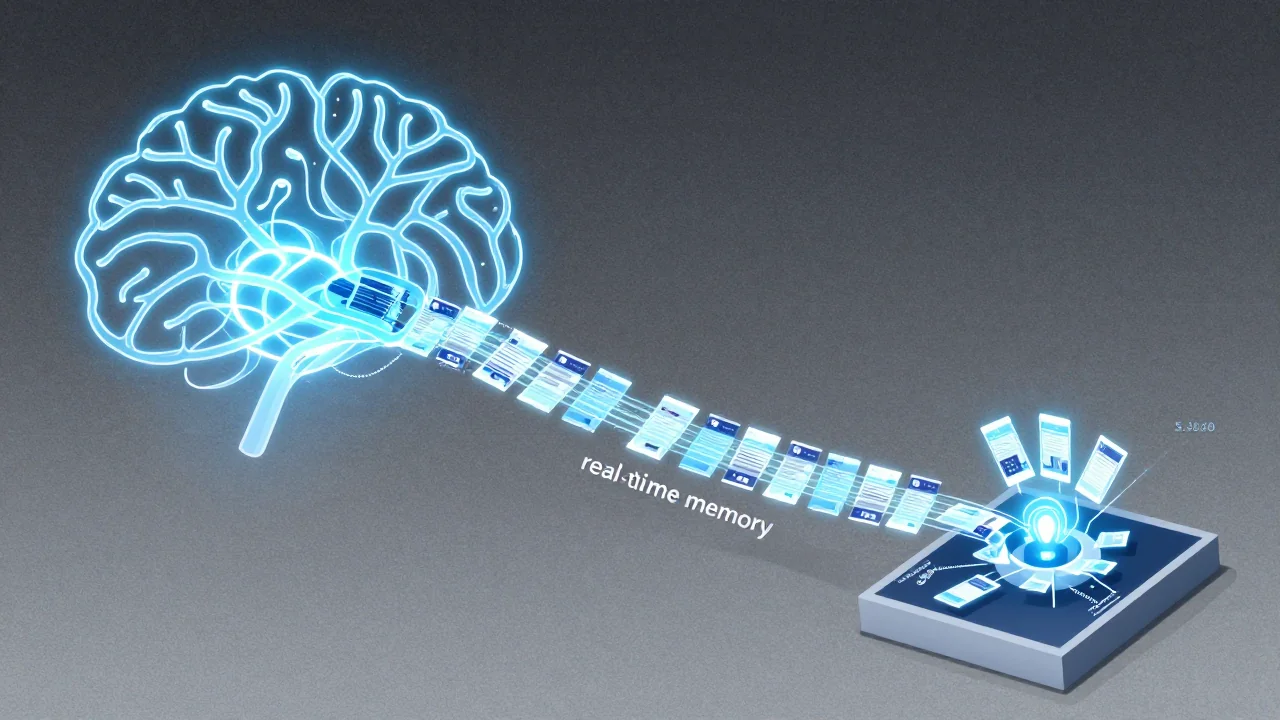
LLM의 추론 메모리 상태를 다른 크기의 모델로 전송하는 기술을 개발했습니다. 컨텍스트 전체 재처리가 아닌 '실시간 기억'만 넘겨주는 것이 핵심입니다.
- 새로운 하이브리드 상태 전송 패키지(GDN)를 적용하여, 4B에서 9B로 모델 크기가 변해도 메모리 손실을 최소화하고 높은 성능을 유지했습니다.
- 이 기술은 LLM의 추론 과정을 여러 단계에 걸쳐 효율적으로 운영하게 하여, 모델 구동 비용과 시간을 획기적으로 절감할 잠재력을 가집니다.
- 현재는 특정 모델 쌍 및 단방향 전송 환경에서만 테스트가 진행되었으며, 범용적인 메모리 동등성이나 일반 인터페이스 구축은 추가 검증이 필요합니다.
본 연구는 언어 모델()이 추론 중인 '실시간 기억' 상태를 다른 크기의 모델로 전달하는 방법을 제시합니다. 기존 방식처럼 전체 컨텍스트를 다시 읽을 필요 없이, 아키텍처가 일치된 Qwen3.5 4B에서 9B로의 하이브리드 모델 간 지속적인 재귀 추론 상태 전송이 가능함을 입증했습니다. 이는 타겟 접두사 재생(target prefix replay) 없이 이루어진 최초의 크로스-모델 메모리 핸드오프 사례입니다.
새롭게 추가된 Gated DeltaNet (GDN) 영구 상태 패키지를 적용한 결과, 교사 강제 음의 로그 우도(NLL)는 0.747 nats/token 감소하여 모든 PG19 문서에서 성능이 향상되었습니다. 또한, 직접적인 재귀 및 컨볼루션 재사용 방식은 테스트된 학습된 GDN 맵보다 우수한 성능을 보였습니다. 여기에 추가된 434,176개 의 수정 컴포넌트는 웹 문서 64개를 기반으로 지속성 손실(continuation loss)이 native 9B 대비 0.076 nats/token 수준임을 확인했습니다.
현재까지의 증거는 단일 방향, 기하학적으로 일치하는 베이스 모델 쌍 및 4K개의 교사 강제 연속 추론에 국한됩니다. 연구진은 이 과정에서 근접 네이티브 게이트가 실패했으며, 16K 분기(branch)는 실행되지 않았다고 밝혔습니다. 따라서 일반적인 상태 인터페이스 구축이나 자유 생성 동등성 등은 아직 입증되지 않은 영역입니다.
용어 풀이
- LLM
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.
- 파라미터
- 모델이 학습하면서 조정한 내부 숫자. 개수가 많을수록 대체로 모델이 크고 무거워요.