물품 호환성 그래프 기반의 1차원 빈 패킹 최적화 연구
Deep Reinforcement Learning on Item-Compatibility Graphs for One-Dimensional Bin Packing
 arXiv
물류, 제조 등에서 난제로 여겨지는 1차원 빈 패킹 문제를 해결하기 위해, 연구진은 물품 간 호환성을 그래프로 모델링한 새로운 강화 학습 프레임워크를 제시했습니다.
- 이 방법론은 그래프 신경망과 강화 학습을 결합하여 최적화 성능을 높였으며, 복잡한 솔버 없이도 기존 최고 수준의 알고리즘에 필적하는 안정적인 결과를 달성했습니다.
- 해당 기술은 물류 창고 관리나 클라우드 자원 배치 등 공간 활용이 중요한 산업 전반에서 효율성을 극대화할 수 있는 실질적인 기반을 제공합니다.
- 전체 성능 비교에서는 여전히 유전 알고리즘이 우위를 보였으나, 본 방법론의 뛰어난 일반화 능력과 안정성은 데이터 기반 최적화의 가능성을 입증했습니다.
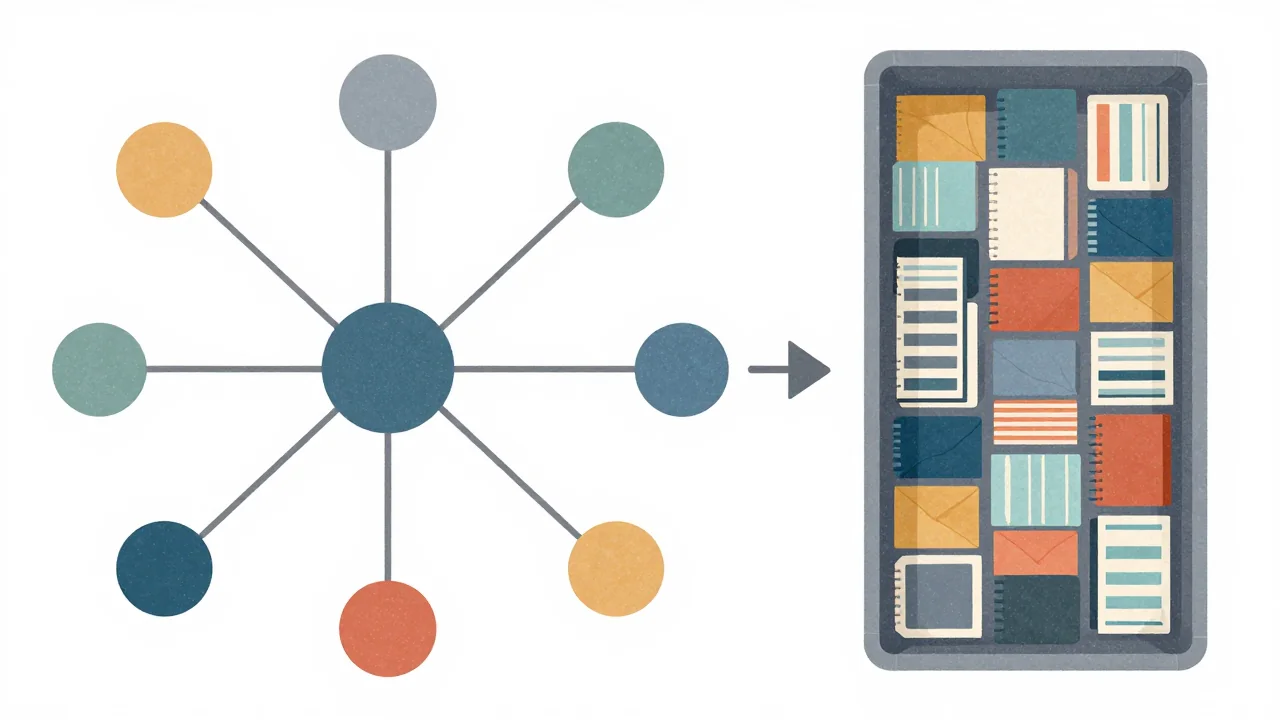
본 논문은 물류 및 제조 분야에서 난제로 여겨지는 1차원 빈 패킹 문제(1D-BPP)를 해결하기 위한 새로운 접근법을 제시합니다. 기존의 심층 (DRL) 방법론들은 주로 2D 또는 3D 변형에 초점을 맞추었으며, 1D-BPP에 대한 지능적인 학습 솔버는 부족했습니다. 연구진은 패킹 과정을 아이템 호환성 그래프 기반의 마르코프 결정 과정으로 공식화하고, 이를 통해 구조적 지식 표현을 활용하는 새로운 종단 간(end-to-end) 프레임워크를 개발했습니다.
제안된 방법론은 그래프 신경망 액터-크리틱 정책을 사용하여 이 호환성 그래프에서 관계형 특징을 추출합니다. 이 모델은 강화 학습을 통해 훈련되며, 확률적 빔 검색(stochastic beam search)으로 디코딩되어 단일 훈련 모델이 크기에 관계없이 으로 일반화할 수 있도록 설계되었습니다.
실험 결과에 따르면, 본 데이터 기반 정책은 기존의 구성적 휴리스틱 방법론의 평균 최적성 격차를 2.66%에서 2.31%로 낮추는 성과를 보였습니다. 특히 가장 어려운 계열에서는 컬럼 생성 및 정수 계획법에 의존하는 최신 학습 솔버보다 우수한 성능을 달성했으며, 자체적으로 어떤 솔버도 사용하지 않았음에도 불구하고 높은 안정성을 입증했습니다.
용어 풀이
- 강화 학습
- 행동의 결과에 보상을 주면서 더 나은 행동을 익히게 하는 학습 방법.
- 제로샷
- 예시를 하나도 주지 않고 바로 과제를 시키는 방식.
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.