모델 간 실패를 활용한 텍스트 지식 증류 기법
Robust Failure, Conservative Repair: Textual Knowledge Distillation from Cross-Model Failures
 arXiv
AI 모델의 오류를 분석해 지식을 전수하는 방식에 안정성 문제가 있었습니다. 이에 연구진은 여러 모델의 공통 실패 지점을 활용하여 지식을 보강하는 ‘RFCR’을 제안했습니다.
- RFCR은 다수 모델의 공동 실패 사례에서 규칙을 추출하고, 적용 범위를 명확히 제한해 지식을 강화합니다. 이 덕분에 BIG-Bench Hard 테스트 등에서 기존 대비 높은 정확도 향상을 입증했습니다.
- 단순한 지식 추가를 넘어, 모델이 규칙을 적용할 '판단 경계'를 설정하는 것이 핵심입니다. 이는 AI 시스템의 추론 과정에 높은 신뢰성과 견고성을 부여합니다.
- 특히, 유효한 규칙이 아니거나 경계가 불분명할 때는 개입하지 않는 ‘보수적 복구’ 원칙을 따릅니다. 이 덕분에 기존의 높은 성능을 유지하며 정확도를 끌어올릴 수 있습니다.
실패 기반의 텍스트 는 모델이 수행하는 과제 오류를 분석하여 지식 격차(gaps)를 발견하고, 이 지식을 해당 모델과 다른 모델들의 추론에 활용하는 것을 목표로 합니다. 다만, 이러한 지식 전이는 안정적이지 않을 수 있습니다. 연구진은 독립적인 규칙을 텍스트 입력에 주입하는 '규칙 원자(rule atom)' 개념을 정의했으며, 이는 과제 지식이나 특정 모델의 추론 패치를 인코딩할 수 있지만, 관련 없는 사례에 오용되어 답변이 잘못 바뀔 위험도 존재합니다.
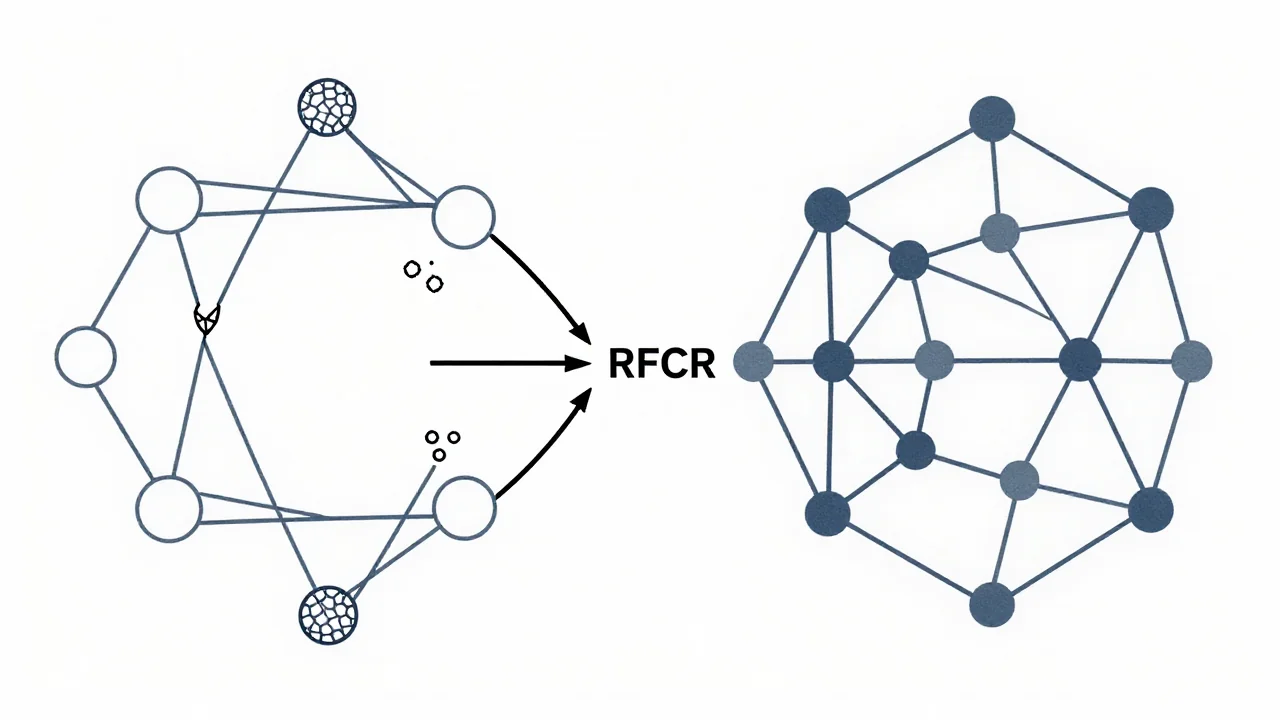
이를 개선하기 위해 '견고한 실패, 보수적 복구(Robust Failure, Conservative Repair, RFCR)'라는 텍스트 증류 절차가 제안되었습니다. 이 방법은 여러 모델에서 공통적으로 발생하는 실패 지점으로부터 규칙을 도출하고, 경계 사례를 사용하여 적용 범위를 명확히 합니다. 또한 유용한 규칙이 발견되지 않을 때는 개입하지 않는 '보수적 복구' 원칙을 따릅니다.
실험 결과에 따르면, RFCR은 400개 항목으로 구성된 BIG-Bench Hard 테스트 세트에서 기준선(baseline) 치트 시트를 68.50%에서 71.25%로 향상시켰습니다 (+2.75 pp). 이 과정에서 기존에 정확했던 사례의 성능 저하는 없었으며, 이러한 정확도 향상은 새로운 지식 주입과 엄격한 규칙 적용 통제 덕분임이 확인되었습니다.
용어 풀이
- 지식 증류
- 큰 모델의 답을 작은 모델이 따라 배우게 해서 가볍고 빠른 모델을 만드는 방법.