강화 학습 정책의 감사 가능성 연구: 규칙 중복과 행동 일치 문제
Auditability Is Not One Property: Rule Overlap, Behavioural Agreement, and Composition in Reinforcement Learning
 arXiv
복잡하고 불투명한 인공지능(AI)의 강화 학습 정책을 감사 가능한 이산 규칙으로 분석하고 조합하는 새로운 프로토콜을 제안했습니다.
- 단순히 규칙이 중복된다고 해서 항상 동일한 행동을 보장할 수 없으며, 성능 저하는 학습 단계와 실제 적용 환경 간의 불일치 때문임을 규명했습니다.
- 이 연구는 AI가 왜 특정 행동을 하는지 그 작동 원리를 명확히 파악하고, 복잡한 시스템의 신뢰도를 높이는 핵심적인 기준을 제공합니다.
- 따라서 본 프로토콜은 만능의 '해석 가능성'을 제시하기보다, 시스템의 작동 원리를 검증할 수 있는 '경계가 설정된 감사 방법론'임을 이해해야 합니다.
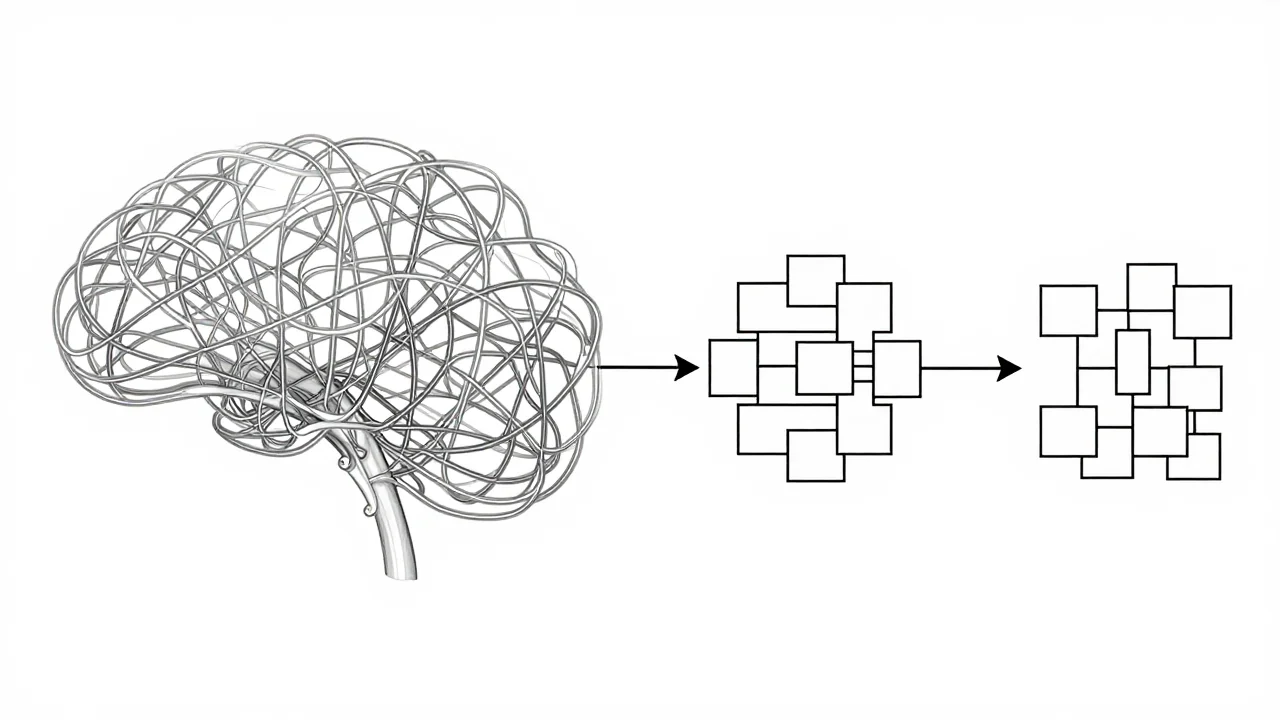
본 연구는 (RL) 정책이 종종 불투명한 신경망 체크포인트로 배포되는 문제를 다루며, 독립적으로 훈련된 정책들을 감사 가능한 이산 행동 규칙을 통해 표현하고 조합할 수 있는지 탐구합니다. 저자들은 감사 가능성을 추적 무결성(trace integrity), 손실 없는 코딩(lossless coding), 규칙 커버리지, 행동 일치성(behavioral agreement) 등 여섯 가지 독립적으로 테스트 가능한 술어로 정의하고, 이를 위한 구체적인 프로토콜을 제시했습니다.
연구 결과에 따르면, 단순히 규칙 세트가 중복된다고 해서 반드시 동일한 행동적 일치를 보장하지는 않습니다. 정책들이 상징적 규칙을 공유하더라도 새로운 상태에서는 무작위 근사 매칭(near-chance-matching) 행동을 선택할 수 있습니다. 또한, 관찰된 융합 실패는 종종 유도 단계와 배포 단계 간의 불일치에서 기인하는 것으로 분석되었습니다.
따라서 본 프로토콜은 보편적인 해석 가능성이나 자율적인 기술 생성 주장을 하는 것이 아니라, 시스템 작동 원리를 검증할 수 있는 '증거에 경계가 설정된 감사 및 조합 프로토콜'을 제공함을 강조합니다. 이 연구는 복잡한 AI 시스템의 신뢰도를 높이는 기준점을 제시하는 데 초점을 맞추고 있습니다.
용어 풀이
- 강화 학습
- 행동의 결과에 보상을 주면서 더 나은 행동을 익히게 하는 학습 방법.