LLM 기반 역할극 에이전트 학습을 위한 적대적 커리큘럼
Adversarial Closed-Loop Curriculum for Evolving Role-Playing Agents
 arXiv
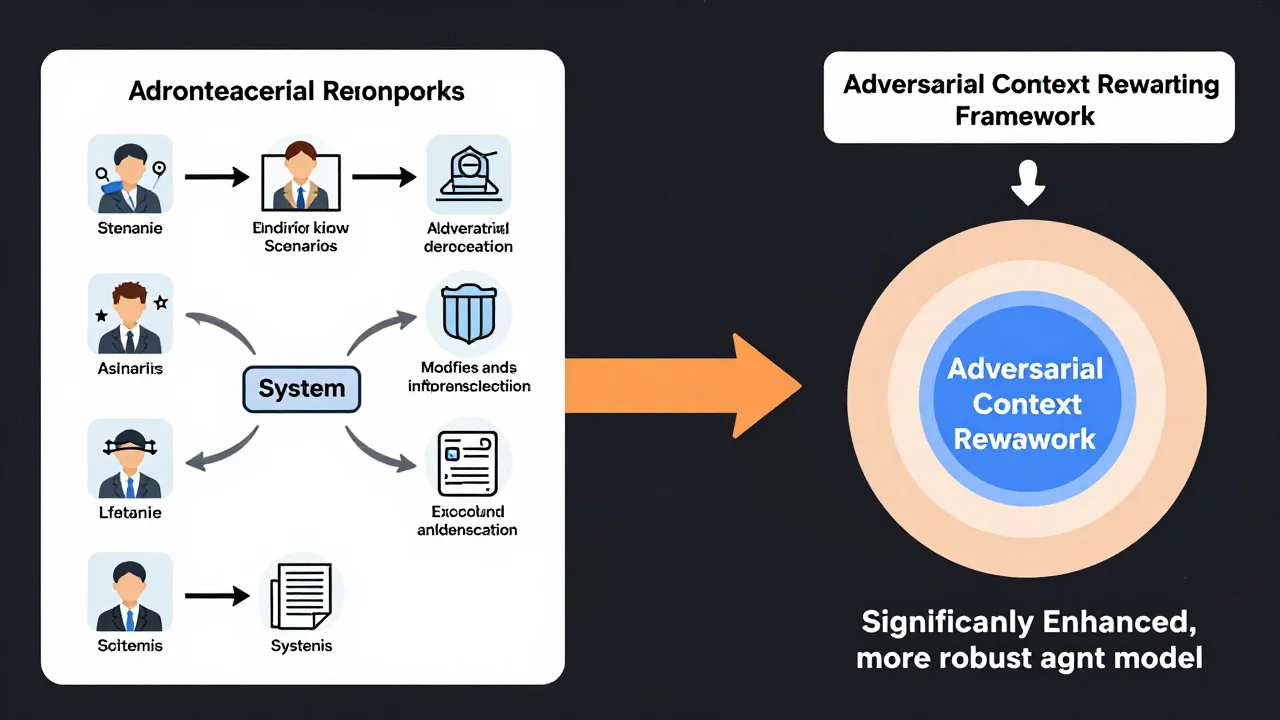
LLM 기반 역할극 에이전트 훈련 시, 기존 방식은 고정된 시나리오 풀에 의존해 성능 향상에 한계를 가졌습니다. 이에 연구진은 적대적 문맥 재작성 프레임워크 AdvRole을 제안했습니다.
- AdvRole은 '에이전트(Actor)'와 '재작성기(Rewriter)'가 상호 작용하는 폐쇄 루프 커리큘럼을 구축합니다. 재작성기는 에이전트의 약점을 찾아내어 난이도를 높인 맞춤형 시나리오를 지속적으로 생성합니다.
- 이는 AI 에이전트가 주어진 환경에만 머무르지 않고, 스스로 취약점을 파악하며 점진적으로 성장하는 방식으로 역할극 능력을 근본적으로 끌어올릴 수 있음을 의미합니다.
- 본 연구는 영어 및 중국어 등 다양한 역할극 벤치마크에서 기존 대비 뛰어난 성능을 입증했으며, 새로운 다국어 평가 환경까지 공개하여 활용도를 높였습니다.
(LLM) 기반의 역할극 는 개인화된 지원이나 사회 시뮬레이션 등 다양한 분야에 응용되고 있습니다. 하지만 기존의 (RL) 방법들은 학습 시작 전에 수집된 고정된 시나리오 풀에 의존하는 경향이 있어, 에이전트가 성능을 향상시킬수록 취약점이 변화함에도 불구하고 훈련 분포가 정적이라는 한계(분포적 병목 현상)를 가집니다. 이에 연구진은 역할극 RL을 폐쇄 루프 커리큘럼으로 전환하는 적대적 문맥 재작성 프레임워크인 AdvRole을 제안했습니다.
AdvRole은 역할을 수행하는 에이전트(Actor)와 캐릭터 프로필 및 대화 맥락을 수정하는 재작성기(Rewriter)가 상호 작용하며 폐쇄 루프를 구축합니다. 특히, Rewriter는 현재 Actor의 점수를 기준으로 원래 시나리오 대비 성능 격차를 줄이는 방향에 보상을 받는 방식으로 훈련됩니다. 이 메커니즘은 에이전트의 약점을 찾아내어 난이도를 높인 맞춤형 시나리오를 지속적으로 생성합니다.
그 결과, 시나리오 풀 자체가 Actor와 함께 진화하며 캐릭터-맥락 공간 내에서 아직 충분히 숙달되지 않은 영역을 끊임없이 목표로 삼게 됩니다. 본 연구는 영어 및 중국어를 포함한 세 가지 역할극 와 새로 공개된 다국어 벤치마크에서 AdvRole이 기존 방식 대비 일관되게 우수한 성능을 보임을 실험적으로 입증했습니다.
용어 풀이
- 대규모 언어 모델
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.
- 에이전트
- 목표를 받으면 스스로 계획을 세우고 도구를 써서 여러 단계의 작업을 해내는 AI.
- 강화학습
- 행동의 결과에 보상을 주면서 더 나은 행동을 익히게 하는 학습 방법.
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.