리서치 연구
MoVISA: 비디오 객체 분할을 위한 다중 토큰 추론 기술
MoVISA: Multi-Token Reasoning for Video Object Segmentation
 arXiv
기존 비디오 객체 분할 기술은 단일 토큰 사용의 한계로 인해 여러 객체를 시간적 맥락에서 정밀하게 추적하는 데 어려움이 있었습니다.
세 줄 요약
- MoVISA는 다중 세그멘테이션 토큰을 도입하여 언어 프롬프트와 시공간 마스크 예측 간의 연계를 강화, 성능과 해석력을 동시에 개선했습니다.
- 이 기술은 영상 속 복잡한 여러 객체를 시간적 맥락까지 고려해 분리하고 추적할 수 있게 함으로써 비디오 분석 및 이해도를 높이는 데 기여합니다.
- MeViS 등 까다로운 벤치마크에서 성능을 입증했으며, 관련 코드와 모델은 추후 공개될 예정입니다.
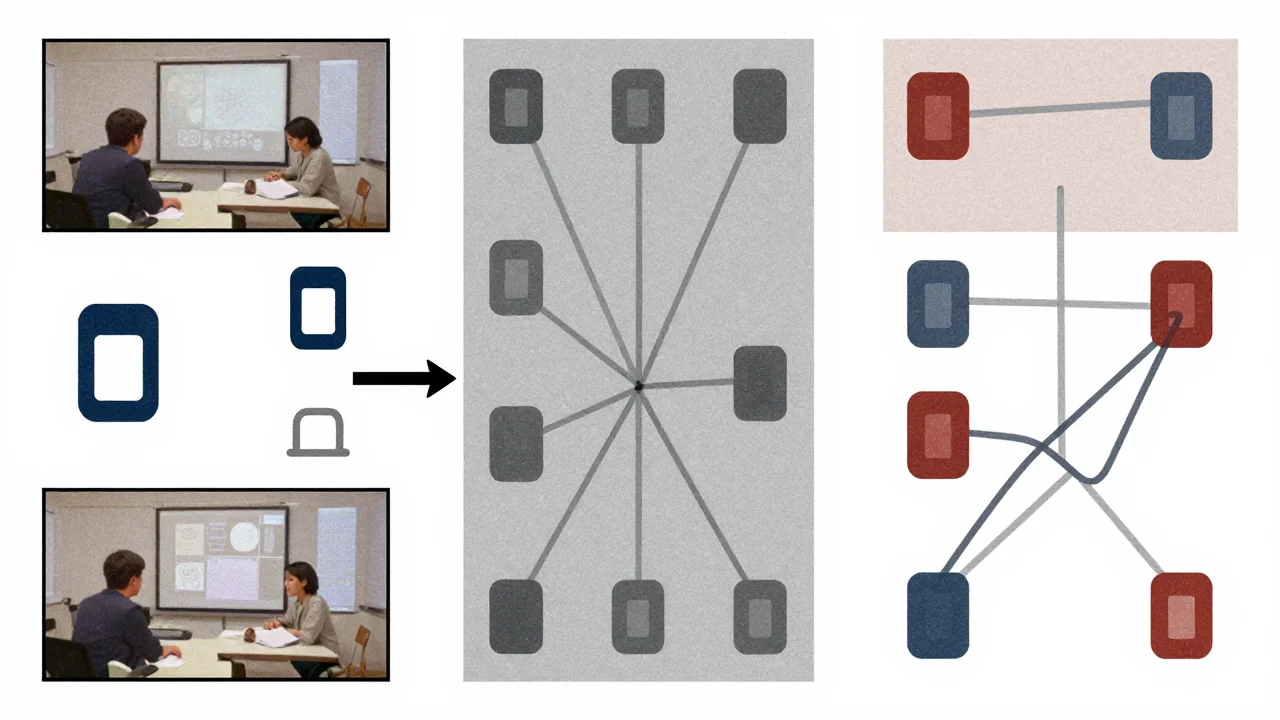
기존의 비디오 객체 분할 기술은 Large Language Model (MLLM) 추론을 활용하여 단일 텍스트 (예: SEG)만으로 이미지 및 영상 전반에 걸쳐 마스크를 예측하는 방식을 사용해왔습니다. 그러나 이러한 단일 토큰 전략은 시간적 맥락에서 여러 객체를 정밀하게 국소화하는 데 필요한 충분한 세분성을 갖추지 못한다는 한계가 관찰되었습니다.
이러한 제한점을 해결하기 위해 MoVISA(Multi-Token Reasoning for Video Object Segmentation)를 개발했습니다. MoVISA는 객체를 여러 프레임에 걸쳐 표현하기 위해 SEG0, SEG1과 같은 다중 세그멘테이션 토큰을 사용합니다. 이 설계는 언어 와 시공간 마스크 예측 간의 보다 정교한 정렬을 가능하게 하여 성능과 해석력을 동시에 향상시키는 것이 특징입니다.
MoVISA 모델은 MeViS, DAVIS17, ReVOS, Ref-Youtube-VOS 등 까다로운 에서 테스트되었습니다. 그 결과, MeViS에서는 J와 F 지표 모두 13.2%의 개선을 달성했으며, ReVOS에서도 J와 F 지표 모두 8.4%의 개선을 기록했습니다. 관련 코드와 모델은 추후 공개될 예정입니다.
용어 풀이
- Multimodal
- 글뿐 아니라 이미지·음성·영상처럼 여러 형태의 입력을 함께 다루는 것.
- 토큰
- AI 모델이 글을 처리하는 단위. 단어보다 작은 조각이며 사용량과 요금을 셀 때 기준이 돼요.
- 프롬프트
- AI에게 주는 지시나 질문 글.
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.