학습 없는 경로 라우팅으로 비디오 확산 가속화
Accelerating Video Diffusion via Training-Free Trajectory Routing
 arXiv
비디오 확산 모델은 연산 비용이 매우 높아 활용에 어려움이 있었는데, 연구진은 대형/소형 모델을 단계별로 교체하는 'TRACK'이라는 효율적인 추론 전략을 개발했습니다.
- TRACK은 두 모델의 예측값 차이를 분석하여 불일치 점수를 산출하고, 품질 민감도가 높은 구간에만 대형 모델을 사용하도록 자동 라우팅합니다.
- 이 기술은 별도의 재학습이나 아키텍처 변경 없이도 비디오 확산 과정을 가속화하여, 고품질 영상 생성을 빠르고 실용적으로 구현할 수 있습니다.
- 추론 과정에서 두 모델의 예측값을 비교하는 추가적인 계산(보정) 단계가 필요하며, 이는 효율적인 추론을 위한 핵심 전처리 과정입니다.
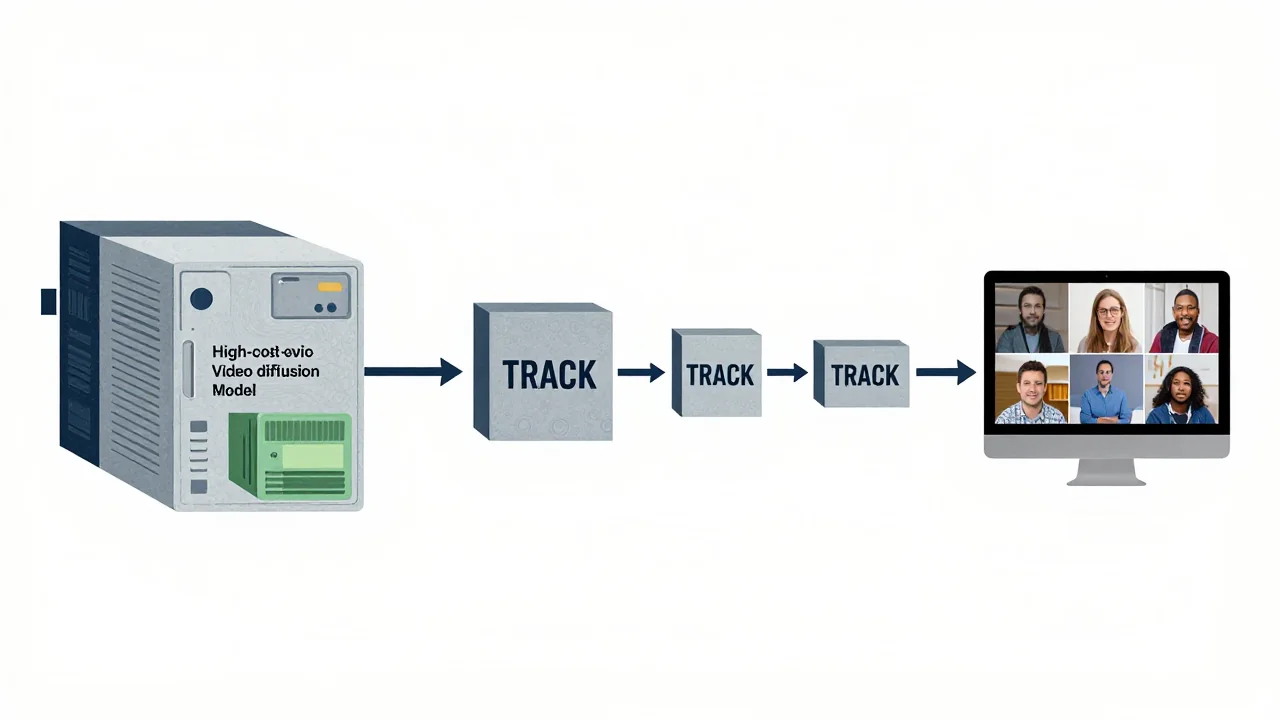
비디오 은 많은 수의 디노이징 단계를 거쳐야 하므로 연산 비용이 매우 높다는 문제가 있습니다. 연구진은 이러한 문제를 해결하기 위해 TRACK(TRajectory-Aware Capacity routing)이라는 이종 디노이징 전략을 제안했습니다. TRACK은 적절한 단계에서 대형 모델과 소형 모델 사이를 전환하며 작동하여, 평균적인 디노이징 평가당 비용을 줄이는 것을 목표로 합니다.
TRACK의 핵심 메커니즘은 보정(calibration) 과정을 통해 이루어집니다. 먼저 대형 모델을 사용하여 기준 궤적을 생성한 후, 각 단계에서 소형 모델의 예측값과 대형 모델의 예측값을 비교하여 상대적인 불일치 점수(relative disagreement score)를 얻습니다. 이 점수를 바탕으로 확산 단계 전반에 걸친 불일치 점수 지도가 생성되며, 이를 통해 효율적인 추론 정책이 결정됩니다.
이렇게 결정된 스위칭 정책에 따라 품질 민감도가 높은 단계에서는 대형 모델을 사용하고, 불일치 점수가 낮은 단계는 소형 모델로 라우팅합니다. 이 방식은 재학습이나 아키텍처 변경 없이도 작동하며, Wan 2.1에서 $1.95 imes$, Cosmos 3에서 $2.04 imes$-$2.73 imes$, TurboDiffusion에서 $2.69 imes$, FastVideo에서 $2.17 imes$의 속도 향상을 달성했습니다.
용어 풀이
- 확산 모델
- 잡음에서 시작해 조금씩 다듬으며 이미지나 영상을 만들어 내는 생성 모델.