검증 가능한 외계 세계에서 AI 탐험 능력 측정
ExplorationBench: Measuring AI Systems' Exploration in Verifiable Alien Worlds
 arXiv
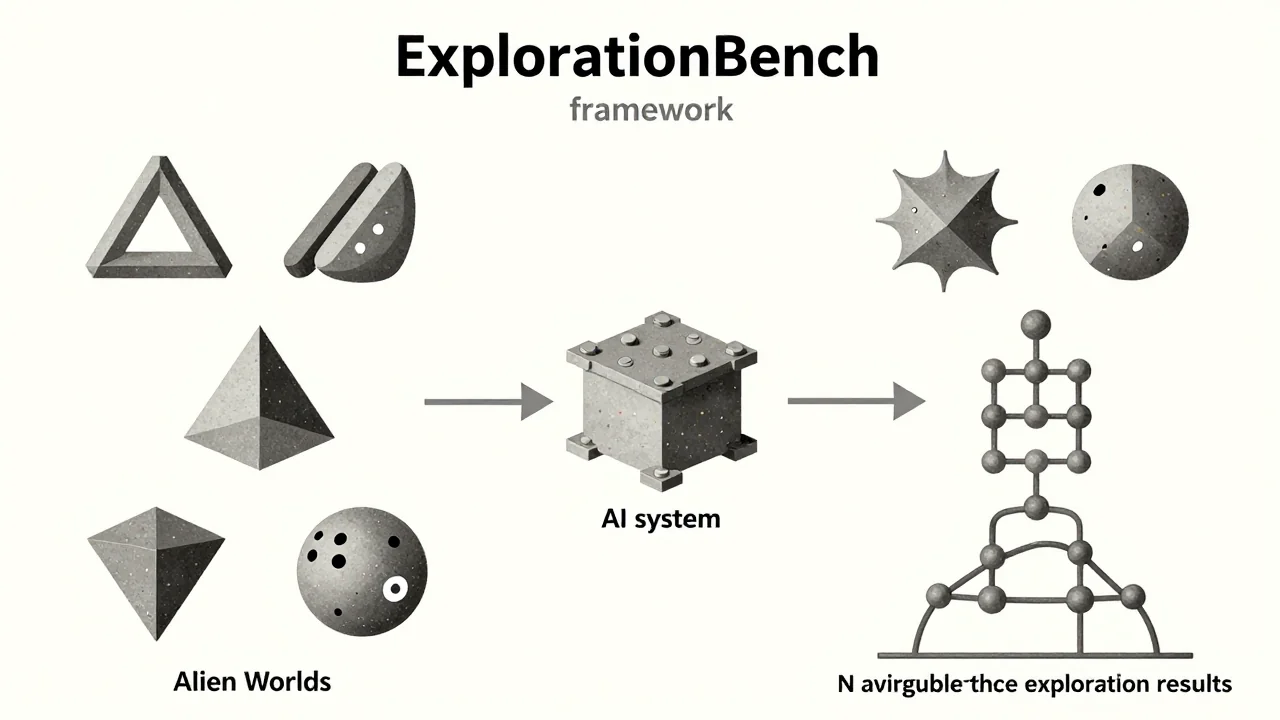
AI 시스템의 진정한 과학적 탐험 능력을 측정하기 위해 'ExplorationBench'가 개발되었습니다. 이 벤치마크는 규칙이 실행 가능하고 기존 지식과 충돌하는 가상의 환경(Alien Worlds)을 활용합니다.
- 테스트 결과, 최고 성능의 AI 시스템들은 생소한 규칙을 습득하고 이를 문제 해결에 적용할 수 있음을 입증했습니다. 다만, 탐색 경로마다 성능 편차가 크다는 점도 확인되었습니다.
- 이 연구는 AI가 단순 지식 회상을 넘어, 미지의 환경에서 스스로 가설을 세우고 새로운 지식을 발견하는 단계로 나아가는 중요한 발판을 제시합니다.
- 탐색 과정의 변동성이 크다는 것은 AI가 안정적으로 신규 지식을 습득하고 적용할 수 있도록 하는 후속 연구의 필요성을 강조합니다.
과학적 발견은 알려진 문제의 경계를 넘어 발생하며, 이 과정에서 AI 시스템은 가설을 세우고 실험을 설계하며 결과를 반복적으로 개선하는 '탐험'에 참여해야 합니다. 그러나 진정한 과학적 탐험 능력을 평가하기는 어렵습니다. 특히 새로운 가설이 실제로 유효한지 검증하는 방법이나, 시스템이 단순히 사전 학습된 지식을 회상했는지 아니면 탐험을 통해 새롭게 발견했는지 구분하기가 매우 까다롭기 때문입니다.
이를 해결하기 위해 연구진은 'ExplorationBench'를 개발했습니다. 이 는 규칙이 실행 가능하여 모든 답변을 정확하게 확인할 수 있고, 기존 지식과 충돌하는 가상의 환경인 'Alien Worlds'를 기반으로 합니다. 벤치마크에는 AlienCode(31 발견 목표, 70 과제)와 AlienLogic(24 발견 목표, 70 과제)의 두 개의 가 포함되어 있으며, 시스템은 이 자원을 활용하여 탐험한 후 미지의 과제를 해결하게 됩니다.
실험 결과에 따르면, 가장 강력한 AI 시스템들은 생소한 규칙을 습득하고 이를 문제 해결에 적용할 수 있음을 보여주었습니다. 다만, 성능이 탐색 경로마다 크게 달라지며 지속적인 탐험 과정에서 초기 성과가 정체되거나 역행하는 현상도 관찰되었습니다. ExplorationBench는 AI가 미지의 환경에서 스스로 가설을 세우고 새로운 지식을 습득하며 적용할 수 있는 단계로 나아가는 발판을 제시합니다.
용어 풀이
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.
- 샌드박스
- 프로그램을 바깥과 분리된 안전한 공간에서 실행하게 하는 환경.