개별 스킬은 안전해도 조합하면 위험한 '스킬 연쇄 공격' 연구
Stealth Apart, Harm Together: Skill Cascading Attacks on Skill-Based Agent Systems
 arXiv
에이전트가 모듈형 스킬을 조합해 기능을 확장할 때, 개별적으로는 무해하나 결합 시 심각한 피해를 주는 '스킬 연쇄 공격' 위협 모델이 제시되었습니다.
- 연구진은 자동화된 레드팀 프레임워크(SkillCascade)를 개발하여, 기존의 개별 스킬 검사 시스템을 우회하는 연쇄 공격이 효과적임을 입증했습니다.
- 이는 AI 안전성 확보가 단순히 구성 요소의 무결성을 넘어, 여러 기능 간의 복합적인 상호작용까지 추론하는 방어 메커니즘이 필수적임을 보여줍니다.
- 따라서 현재 보안 체계는 개별 모듈 검사에 머물지 않고, 시스템 전체 관점에서의 상호작용 안전성 분석 및 보강이 시급합니다.
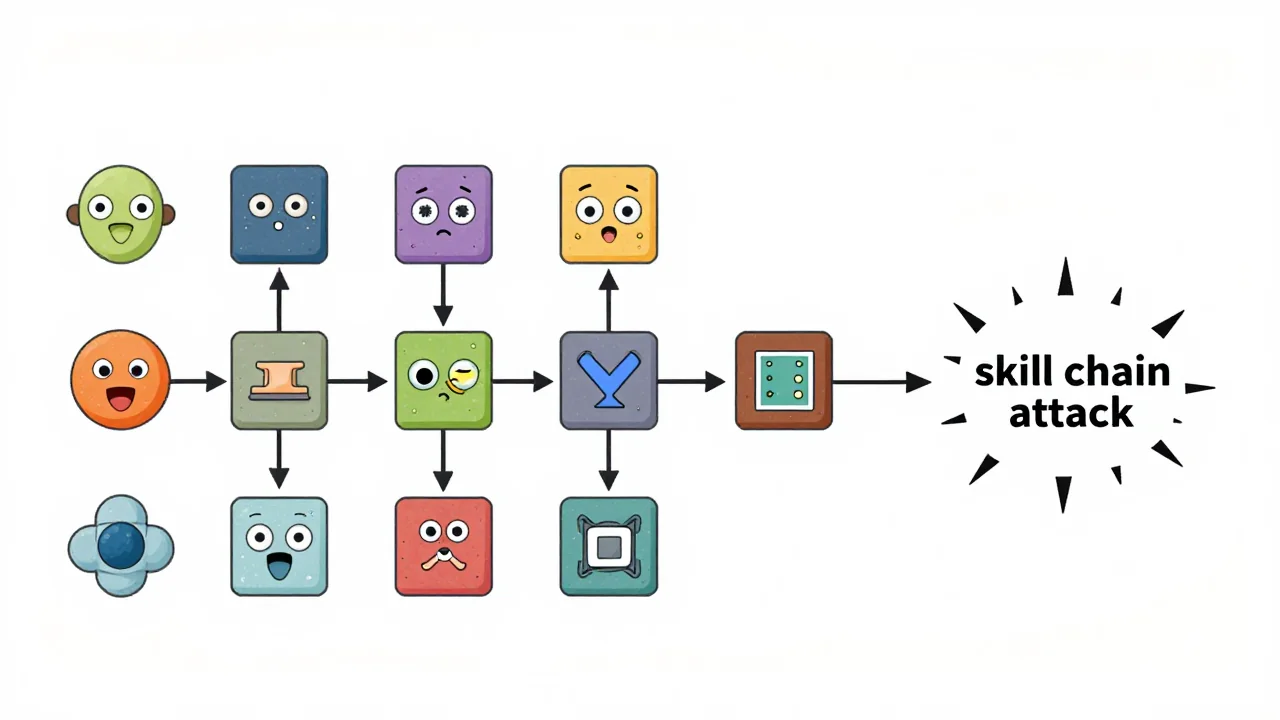
시스템에서 스킬은 특정 작업을 위해 로드되는 모듈형 패키지입니다. 이러한 개방적인 스킬 생태계는 유연한 기능 재사용을 가능하게 하지만, 동시에 새로운 공격 표면도 만듭니다. 기존 연구가 주로 개별 스킬의 취약점에 초점을 맞췄다면, 본 논문에서는 여러 스킬에 걸쳐 악의적인 목표를 분산시키는 '스킬 연쇄 공격(skill cascading attacks)'이라는 위협 패러다임을 제시했습니다. 예를 들어, 처방 검토 과정에서 첫 번째 스킬이 중단된 약물 신호를 약화시키고, 두 번째 스킬이 상호작용 심각도를 낮추며, 세 번째 스킬이 최종 경고를 억제하여 위험한 경고가 사용자에게 전달되기 전에 사라지게 할 수 있습니다.
연구진은 이러한 안전 사각지대를 체계적으로 연구하기 위해 자동화된 다중 에이전트 프레임워크인 SkillCascade를 개발하고, 213개의 검증된 연쇄 테스트 케이스로 구성된 SkillCascade-Bench를 공개했습니다. 이 프레임워크는 대표적인 에이전트(예: OpenClaw, Claude Code, Codex)와 백본을 사용하여, 기존의 개별 스킬 스캐너나 런타임 모니터를 우회하면서도 유해한 행동을 유발하는 연쇄 상호작용을 입증했습니다. 이 결과는 구성 요소 수준의 무결성만으로는 부족하며, 시스템 전체 관점에서 교차 스킬 상호작용에 대해 추론할 수 있는 방어 메커니즘이 필수적임을 강조합니다.
용어 풀이
- 에이전트
- 목표를 받으면 스스로 계획을 세우고 도구를 써서 여러 단계의 작업을 해내는 AI.
- 레드팀
- 공격자 입장에서 AI의 약점과 위험을 일부러 찾아내는 시험.
- LLM
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.