생체공학 AI 성능 측정 글로벌 벤치마크 'BioEVAL'
BioEVAL: A global, multi-institutional benchmark of large language and multimodal models for bioengineering
 arXiv
BioEVAL은 생체공학 분야의 AI 성능을 측정하는 글로벌 벤치마크로, 객관식 문제부터 문헌 합성, 다중 모드 해석까지 총 608개 항목으로 구성되었습니다.
- 주요 LLM(ChatGPT, Gemini 등)은 MCQ에서 최고 90%, 문헌 합성에서 0.72점 등의 고성능을 보였으나, 생체공학 세부 분야별로 성능 편차가 두드러집니다.
- 이 벤치마크는 단순한 지식 회상을 넘어, 실제 연구에 필수적인 실험적 추론과 다중 모드(Multimodal) 이해 능력을 평가하는 새로운 기준을 제시했다는 점에서 중요합니다.
- BioEVAL은 지속적으로 확장 가능한 표준화된 프로토콜로 유지되어 AI 모델의 현황 진단 및 향후 개발 방향 설정에 중요한 참고 자료가 될 것입니다.
BioEVAL(BioEngineering Validation of AI and LLMs)은 생체공학 분야의 실험적 추론 능력을 평가하기 위해 구축된 글로벌 다기관 입니다. 이 벤치마크는 총 11개의 주요 BE 세부 분야와 미분류 항목을 포괄하며, 22개 연구 그룹이 참여하여 PhD 수준의 난이도로 구성되었습니다.
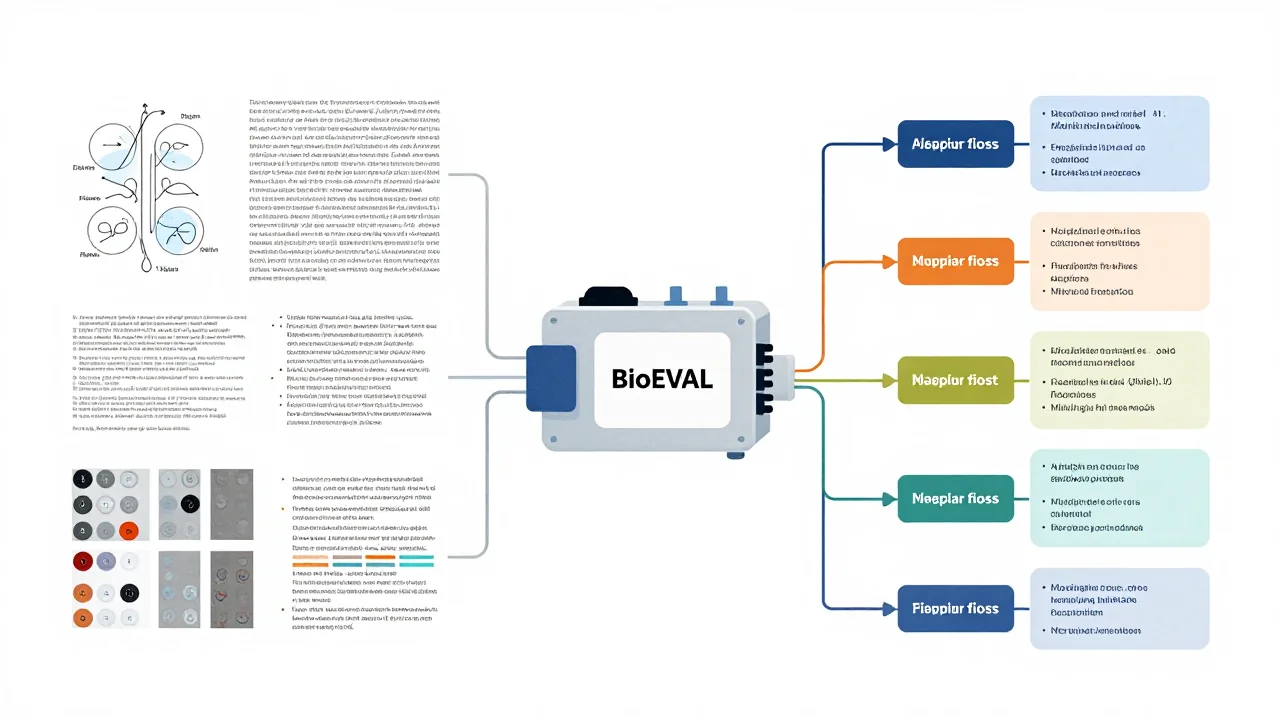
평가 항목은 총 608개로 구성되어 있으며, 구체적으로는 객관식 문제(MCQ) 380개(감사 후 359개 사용), 문헌 합성 과제 218개, 그리고 실험 이미지 해석을 포함한 다중 모드 문제가 10개 포함됩니다. 모든 항목은 작성 그룹 전문가 검토와 중앙 집중식 품질 관리를 거쳤습니다.
ChatGPT, Gemini, Grok 등 다양한 클라우드 기반 및 로컬 배포 모델이 평가되었으며, MCQ에서 최대 90%의 정확도를 기록했고 문헌 합성에서는 유사도 점수 0.72를 달성했습니다. 다중 모드 추론 질문 샘플에서도 80%의 정확도가 보고되었으나, 세부 분야별로 성능 편차가 관찰되었습니다.
BioEVAL은 단순 지식 회상을 넘어선 능력을 측정하며, 향후에도 전문가의 항목 기여와 모델 평가를 위한 표준화된 프로토콜을 갖춘 확장 가능한 벤치마크로 유지될 예정입니다.
용어 풀이
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.