레이블 없는 영상으로 자율주행 행동 모델 학습하는 방법 연구
Action Forcing: Training World Models on Unsupervised Video by Recovering Underlying Egomotion Bases
 arXiv
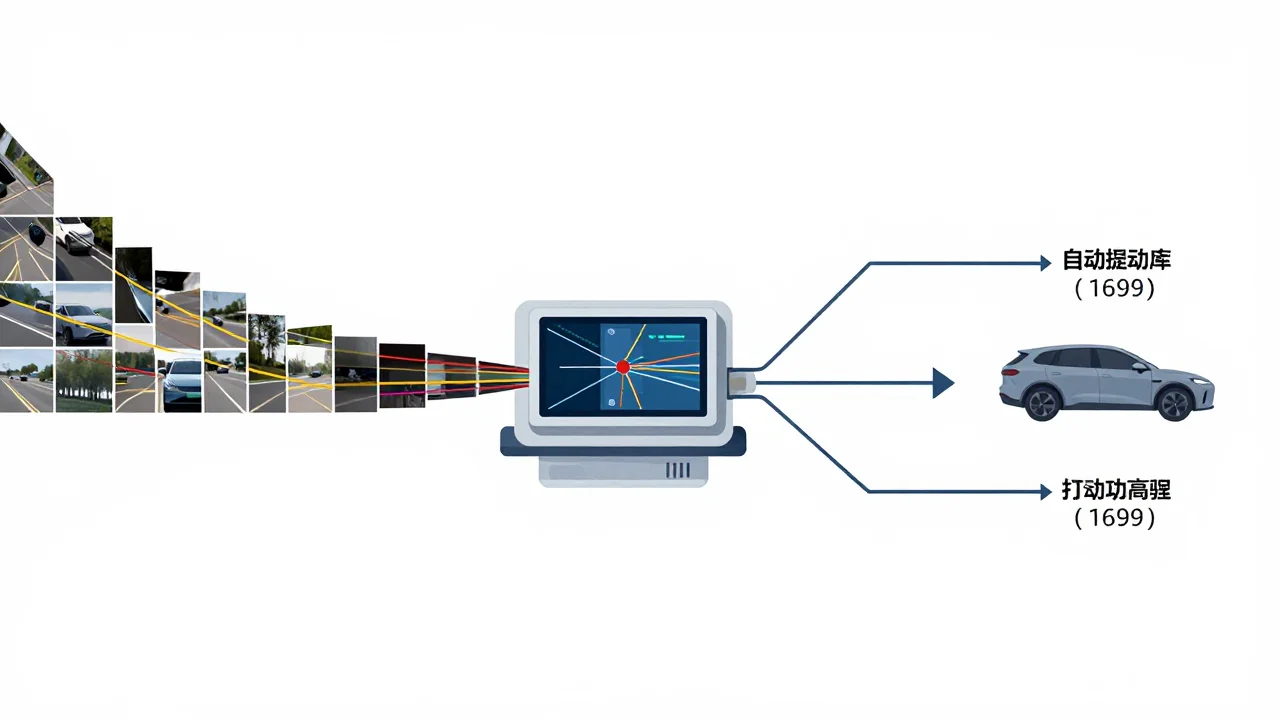
기존에는 고가의 장비나 수동 주석이 필요했던 자율주행 학습 데이터를, 일반적인 레이블 없는 영상에서 움직임(egomotion)을 추출하여 행동 제어 신호로 변환하는 방법을 제시했습니다.
- 해당 모델은 훈련 데이터에 적게 포함된 역방향 이동이나 정지 상태도 안정적으로 처리하며, 가속과 조향 같은 여러 동작 조합 능력을 입증했습니다.
- 자율주행 및 월드 모델 학습의 핵심 난제였던 고품질 행동 주석 데이터셋 확보 문제를 근본적으로 해결할 수 있는 새로운 접근법입니다.
- 다만, 이 방법은 영상에 표현된 움직임 축만을 복구할 수 있으며, 성능 평가 시 기존 지표 대신 기하학적 무결성 등 새로운 기준이 필요합니다.
월드 모델을 제어 가능하게 훈련하려면 동기화된 행동 주석 데이터가 필수적이지만, 이러한 데이터셋은 확보하기 어렵습니다. 본 연구는 일반적인 레이블 없는 비디오를 활용하여, 데이터를 기반으로 한 egomotion 기저를 복구함으로써 이를 행동 감독 훈련 데이터로 변환하는 방법을 제시합니다. 이 과정에서 픽셀 변위를 추적하고 egomotion이 유도하는 일관된 구조를 이용해 실제 제어 신호를 얻을 수 있습니다.
주성분 분석(PCA)과 같은 간단한 방법으로 이를 수행할 경우, 주요 성분들이 부호가 지정되고 확장 가능하며 조합 가능한 스로틀-요(throttle–yaw) 제어를 제공합니다. 이 모델은 훈련 데이터에서 1% 미만인 역방향 동작이나 정지 상태도 학습하여 처리할 수 있으며, 가속과 조향 같은 여러 동작을 조합하는 능력을 보여줍니다.
또한, 기존의 비디오 생성 지표를 평가에 사용하는 것에 대한 한계를 지적하며, 대안적인 참조 없는(reference-free) 평가 방법을 제안합니다. 이 방법은 '제어 가능성', '개연성', '창조 능력', '기하학적 무결성' 등을 측정하여 기존 방식이 놓치던 실패 사례를 밝혀냅니다.