초고해상도 과학 이미지 분석을 위한 구조 기반 MAE 프레임워크
Structure-Guided Masked Autoencoders for Ultra-High Resolution Scientific Image Understanding
 arXiv
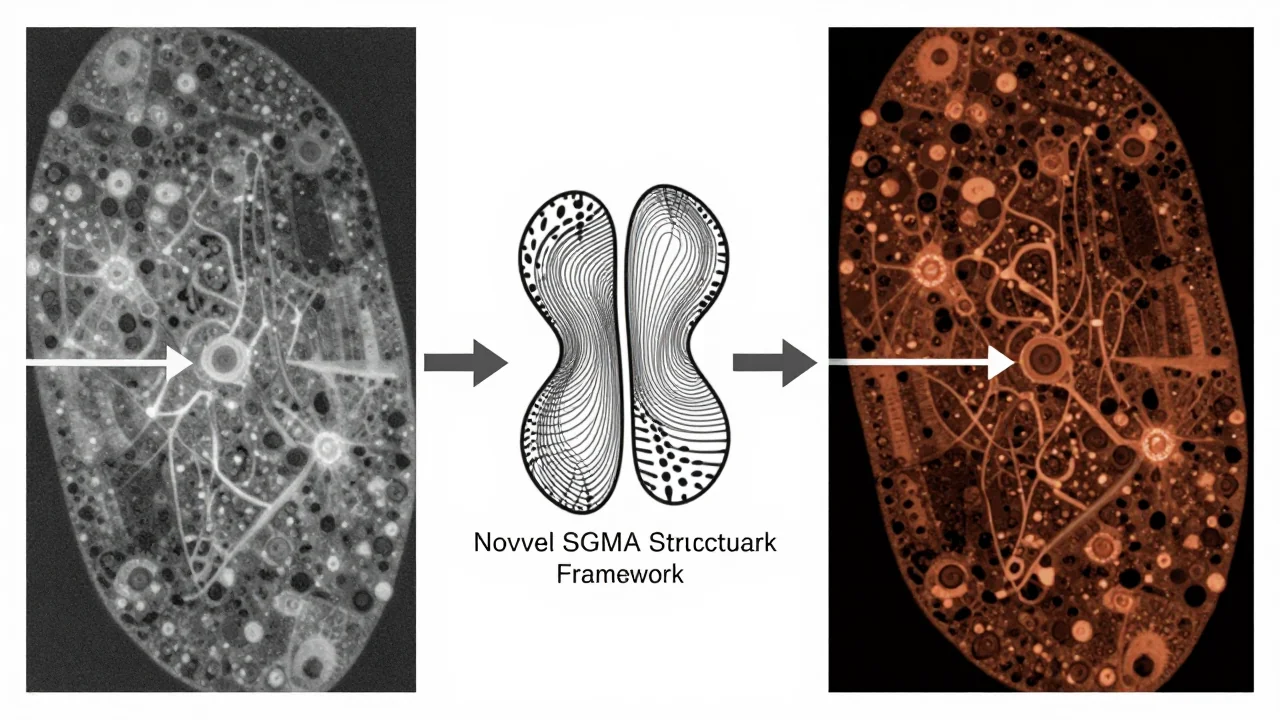
초고해상도 과학 이미지는 기존 MAE 기법 적용이 어려웠는데, 연구진은 이미지의 구조적 특성을 반영하여 정보를 복원하는 새로운 프레임워크 SGMA를 제안했습니다.
- SGMA는 콘텐츠 적응형 쿼드트리 토크나이저와 구조 기반 마스킹을 결합해, 기존 MAE 대비 높은 성능 향상과 최대 24.8배의 빠른 추론 속도를 동시에 달성했습니다.
- 본 연구는 전자현미경이나 전장 슬라이드(WSI) 같은 초대형 과학 데이터 분석의 정확도를 높여 생명과학 및 의학 진단 분야에 혁신적인 도구로 활용될 잠재력이 큽니다.
- 특히, 신호 의존적 응답을 통합하여 마스킹 과정을 안정화시키는 '감쇠 누적(DA)' 기법이 미세 구조 보존과 높은 성능 유지의 핵심 기술입니다.
기존의 Vision Transformer 기반 마스크드 오토인코더(MAE) 기법은 초대형 과학 이미지를 처리하는 데 어려움이 있습니다. 무작위 마스킹은 데이터의 구조적이고 다중 스케일적인 형태와 맞지 않으며, 균일한 화는 $O(N^2)$ 어텐션 계산을 비현실적으로 길게 만듭니다. 이에 연구진은 초고해상도 과학 이미지를 위한 SGMA(Structure-Guided Masked Autoencoding) 프레임워크를 제안했습니다. 이 프레임워크는 콘텐츠 적응형 쿼드트리 와 구조 조건부 마스킹 과정을 결합하여, 초대형 이미지를 고정 길이 시퀀스로 압축하고 공간적으로 정보가 풍부한 영역으로 복원을 유도합니다.
SGMA의 안정성을 확보하기 위해 '감쇠 누적(Damped Accumulation, DA)' 기법이 도입되었습니다. 이 기술은 스케일 전반에 걸쳐 신호 의존적 응답을 집계하여 구조 캔버스를 생성하고, 이를 마스킹 과정에 활용해 미세한 미세구조를 보존하는 데 도움을 줍니다. SGMA는 표준 ViT 인코더 및 MAE 스타일의 복원 방식과 호환되면서도 이러한 과정을 안정화시킬 수 있습니다.
실제 성능 테스트 결과, SGMA는 다양한 과학 데이터셋에서 기존 MAE 기준보다 우수한 성능을 보였습니다. 예를 들어, 8K x 8K x 28K SpringXCT 데이터셋에서는 95.68%의 Dice 점수를 달성하며 동일 아키텍처의 MAE 베이스라인 대비 +13.00 포인트 향상을 기록했습니다. 또한, 32K^2 WSI PAIP 데이터셋에서도 83.21%의 Dice 점수로 +16.84 포인트 개선을 보였으며, 최대 24.8배에 달하는 추론 속도 향상도 입증했습니다.
용어 풀이
- 토큰
- AI 모델이 글을 처리하는 단위. 단어보다 작은 조각이며 사용량과 요금을 셀 때 기준이 돼요.
- 토크나이저
- 글을 모델이 처리할 토큰으로 잘라 주는 도구.