MVAgent: 다중 에이전트를 활용한 일관성 비디오 생성 기술
MVAgent: Multi-Agent Video Generation via Consistent Condition Construction and Shot-Level Policy Optimization
 arXiv
다중 샷 비디오 생성 시 발생하는 캐릭터 외형, 공간 배치 등의 불일치 문제를 해결하는 'MVAgent'라는 다중 에이전트 파이프라인입니다.
- 공간 추적, 관찰자, 전환 에이전트 등이 협력하여 다음 샷의 행동과 공간 참조를 구축하며, 모든 샷 단위로 강화학습을 적용해 일관성을 극대화합니다.
- MVAgent는 ViMax-Bench 테스트에서 최고 수준의 샷 간 일관성과 서사적 기획 품질을 달성했으며, 인간 평가에서도 기존 최강 모델보다 우수함을 입증했습니다.
- 비디오 생성을 '조건 구성' 문제로 재정의하고, 여러 에이전트가 협력하는 정교한 입력 조건(typed conditioning inputs)을 구축하는 것이 핵심 기술 전제입니다.
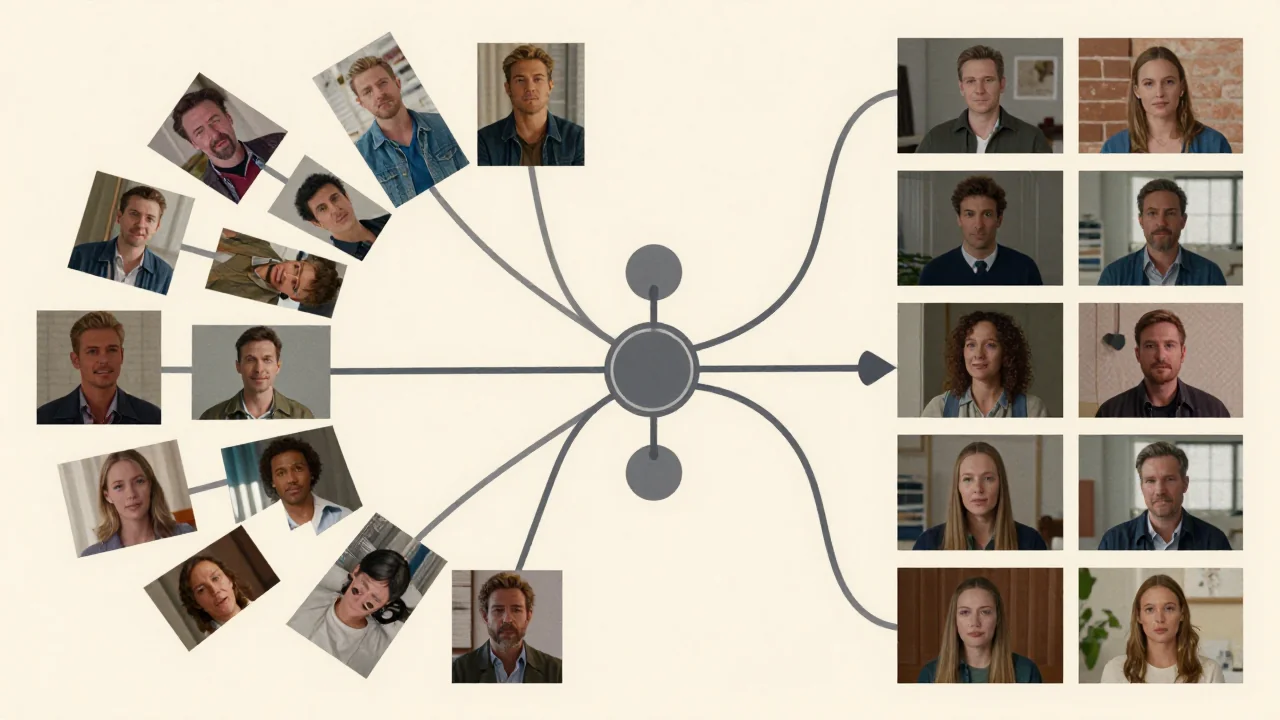
다중 샷(Multi-shot) 기반의 형 비디오 생성을 위해서는 캐릭터 외형의 일관성 유지, 카메라 각도에 따른 안정적인 공간 배치, 그리고 샷 간 연속적인 캐릭터 상태 유지가 필수적입니다. 기존 방식에서 모든 샷을 개별 요청으로 처리할 경우, 반복되는 텍스트 입력만으로는 이러한 외형, 레이아웃 또는 상태를 결정하기 어렵습니다. 이에 연구진은 이 문제를 '조건 구성(condition construction)' 문제로 재정의하고, 여러 에이전트가 유형화된 조건부 입력(typed conditioning inputs)을 통해 협력하는 다중 에이전트 파이프라인인 MVAgent를 제시했습니다.
MVAgent는 각 샷에 필요한 복잡한 조건을 구축하기 위해 여러 전문 에이전트를 활용합니다. 공간 접지 에이전트(Spatial Grounding agent)는 생성된 카메라 이동 클립에서 시점을 샘플링하고, 해당 샷을 프레임으로 연결하는 뷰에 고정시킵니다. 또한 관찰자(Observer)는 각 샷이 끝나는 방식을 연속성 메모리에 기록하며, 전환 에이전트(Transition agent)는 이를 바탕으로 다음 샷의 캐릭터 행동과 공간 참조를 구축합니다. 이 모든 입력은 오케스트레이터가 최종 요청에 조합하여 사용합니다.
MVAgent는 생성된 결과물이 실제로 렌더링된 후에야 효과를 알 수 있다는 점을 고려하여, 트렁크-GDPO(Trunk-GDPO) 기반의 에이전트 으로 모델을 훈련했습니다. 이 방식은 비디오 전체가 아닌 매 샷 단위로 후보들을 비교하고 가장 좋은 결과를 '트렁크'로 이어가는 방식으로 일관성을 극대화합니다. 그 결과, MVAgent는 ViMax-Bench 테스트에서 최고 수준의 샷 간 일관성과 서사적 기획 품질을 달성했으며, 인간 평가에서도 기존 최강 에이전트 기반 모델보다 우수한 성능을 보였습니다.
용어 풀이
- 에이전트
- 목표를 받으면 스스로 계획을 세우고 도구를 써서 여러 단계의 작업을 해내는 AI.
- 강화 학습
- 행동의 결과에 보상을 주면서 더 나은 행동을 익히게 하는 학습 방법.