LLM의 출력 분포 제어를 위한 MaD-RL 프레임워크
MaD-RL: Matching Distributions for Calibrating LLMs with Reinforcement Learning
 arXiv
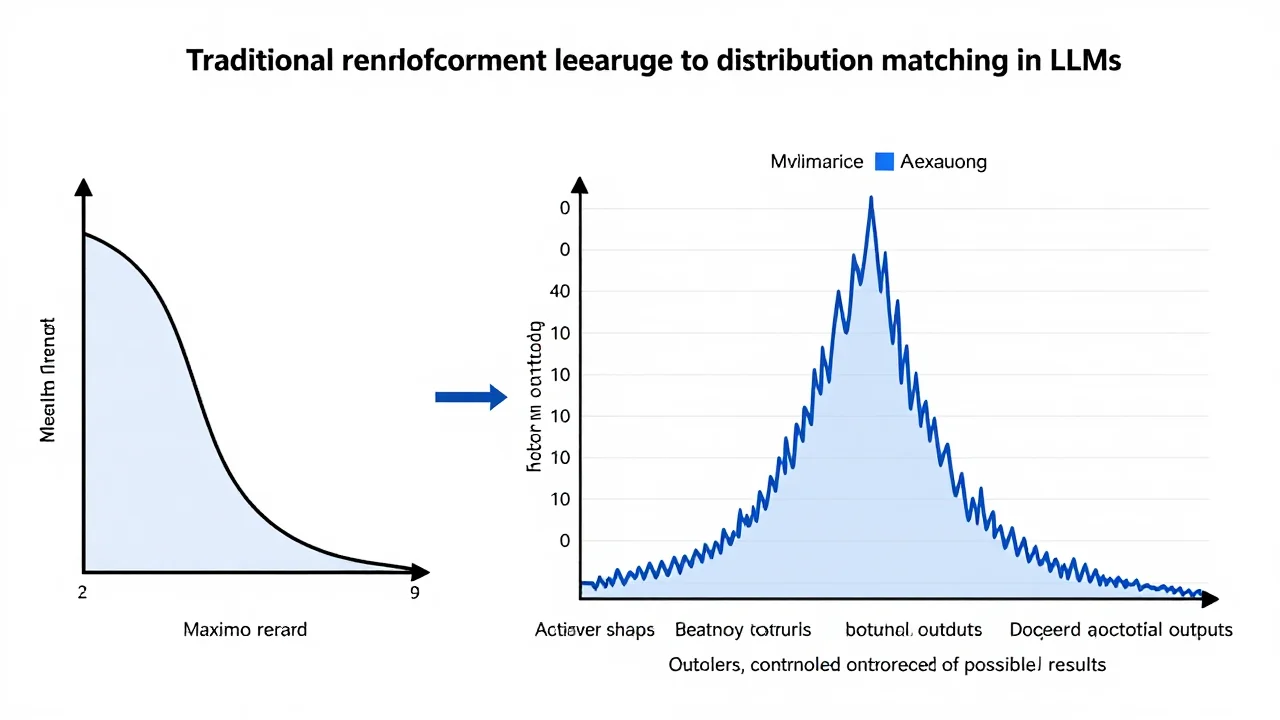
기존 LLM 강화 학습이 단순히 기대 보상 최대화에 초점을 맞췄다면, 본 연구는 출력 결과물의 분포 자체를 제어하는 '분포 매칭(Distribution Matching)' 프레임워크를 제시했습니다.
- 제안된 프레임워크는 모델 출력이 목표 분포를 따르도록 유도하며, KL 발산이나 Jensen-Shannon 같은 다양한 통계적 지표 기반의 보상 함수 구현을 가능하게 합니다.
- 이는 단순히 좋은 답변을 넘어 출력 다양성 제어나 공정성 제약이 필요한 합성 데이터 생성 및 정책 탐색 등 복잡한 AI 응용 분야에 핵심적인 역할을 합니다.
- 기존 방법들이 출력을 특정 모드에 집중시켜 다양성을 저해하는 한계가 있었으며, 본 연구는 수학적 추론 및 코딩 작업에서 그 효과를 입증했습니다.
(RL)은 언어 모델 후처리 과정에서 개별 출력에 할당된 보상을 최대화하는 데 널리 사용되어 왔다. 그러나 생성, 공정성 제약 만족, 정책 탐색과 같은 응용 분야에서는 단순히 기대 보상만 최대화하는 것을 넘어, 모델 출력이 가지는 분포 자체를 제어할 필요가 있다.
본 연구는 '분포 매칭(Distribution Matching)'을 위한 일반적인 RL 기반 프레임워크를 제안한다. 이 프레임워크는 모델 출력의 잠재적 범주형 속성 분포를 지정된 목표 분포와 일치시키는 것을 가능하게 한다. 이를 통해 기존 방법들이 출력을 특정 모드에 집중시켜 다양성을 저해하는 한계를 극복할 수 있다.
제안된 접근 방식은 KL 발산이나 Jensen-Shannon과 같은 다른 통계적 발산 지표를 위한 보상 함수를 이론적 근거와 함께 제시한다. 이는 기존의 Group Relative Policy Optimization (GRPO) 등에서 다루지 않았던 다양한 분포 제어 요구사항을 충족시킨다.
연구진은 이 프레임워크의 효과를 수학적 추론 및 프로그래밍과 관련된 일련의 실험들을 통해 입증하였다. 이를 통해 MaD-RL이 복잡한 AI 응용 분야에서 모델 출력을 정교하게 제어할 수 있음을 보여주었다.
용어 풀이
- 강화 학습
- 행동의 결과에 보상을 주면서 더 나은 행동을 익히게 하는 학습 방법.
- 합성 데이터
- 실제로 모은 것이 아니라 AI나 프로그램으로 만들어 낸 학습용 데이터.