의도 조건부 주거 에너지 관리를 위한 다중 모드 벤치마크
Energy Vision--Language--Action: A Controlled Multimodal Benchmark for Intent-Conditioned Residential Energy Management
 arXiv
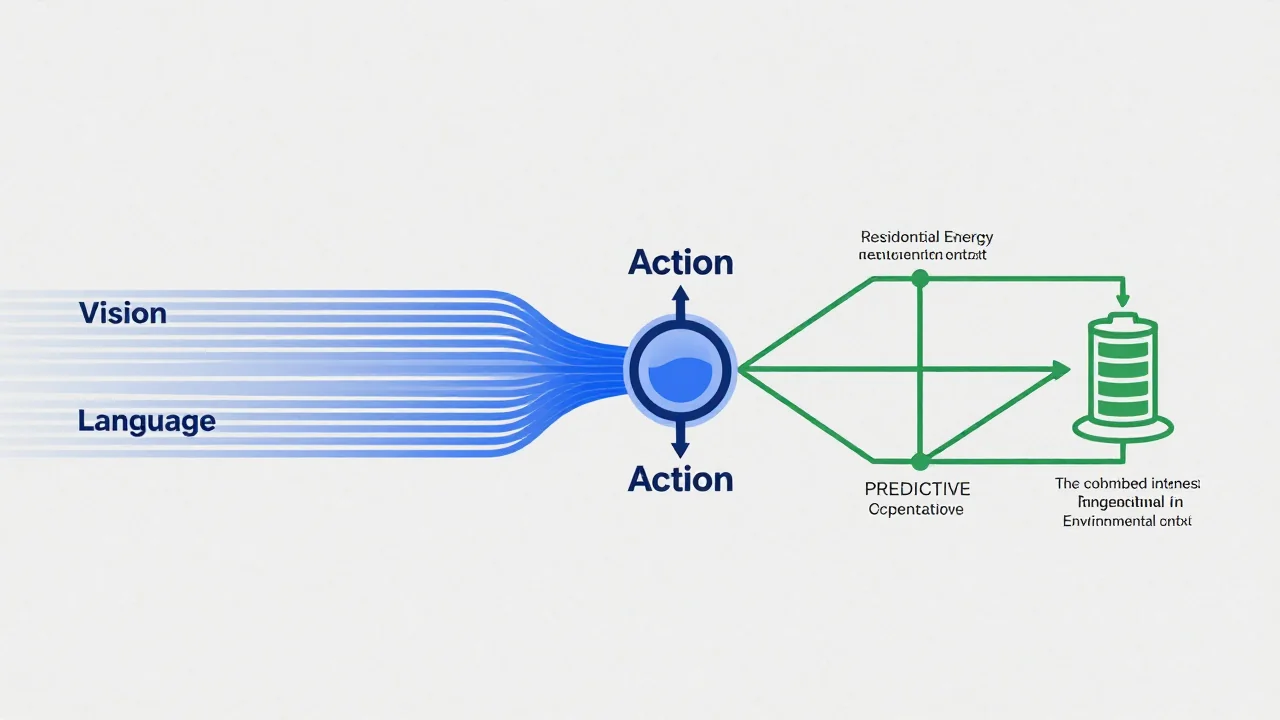
주거 에너지 관리를 위해 시각(Vision), 언어(Language), 행동을 통합한 'EVLA'라는 다중 모드 벤치마크를 개발했습니다. 이 시스템은 사용자의 의도와 환경 정보를 결합하여 배터리 작동 경로를 예측합니다.
- 테스트 결과, 에너지 예측 성능은 자연어 목표(사용자 의도)에 크게 좌우되는 것으로 나타났습니다. 반면, 현재 RGB 시각 정보는 전체 오차 감소에 큰 기여를 하지 않는다는 점이 확인되었습니다.
- 본 연구는 단순한 전력 소비량 예측을 넘어, 인간의 '의도'와 복합적인 환경 맥락이 작용하는 실제 생활 시스템에서의 행동 예측 기준점을 제시했다는 점에서 중요합니다.
- 다만, 현재 도출된 결과는 전체 벤치마크가 아닌 특정 파일럿 세트와 실행된 프로토콜을 기반으로 하므로 이 점을 참고해야 합니다.
본 연구는 Vision-Language-Action() 모델을 활용하여, 주거 환경에서의 의도 기반 에너지 관리를 위한 통제된 다중 모드 인 EVLA를 소개합니다. 이 시스템은 RGB 에너지 필드 표현, 수치적 작동 상태, 그리고 자연어 목표라는 세 가지 입력을 받아 유한 범위의 샘플링 기반 참조 생성기를 통해 16단계 배터리 행동 궤적으로 매핑하는 것을 목표로 합니다.
EVLA는 공공 주거 전기 부하 데이터에서 파생된 소스 창을 사용하며, 전력 가격, 배터리 충전 상태(SoC), 실내 온도, 시간 등의 메타데이터를 포함합니다. 이 과정에서 숨겨진 작동 체제는 에너지 필드 텍스처로만 인코딩되어 시각적 변화가 가능하면서도 명시적인 수치 상태는 고정된 다중 모드 인스턴스가 총 6,588,045개 생성되었습니다.
초기 연구에서는 특정 파일럿 세트를 사용하여 모델을 평가한 결과, 에너지 예측의 품질은 처리된 자연어 경로와 강하게 연관되어 있는 것으로 나타났습니다. 반면, 현재 RGB 경로는 전체 오차 감소 측면에서 우위를 보이지 않았으며, 이는 모달리티 사용에 있어 비대칭성을 보여줍니다.
다만, 이러한 결과는 전체 벤치마크를 대상으로 한 것이 아니라 고정된 파일럿 세트와 실행된 프로토콜을 기반으로 하므로 해석 시 이 점을 고려해야 합니다. EVLA는 의미론적 의도와 잠재적 맥락이 주거 에너지 행동 예측에 미치는 영향을 연구할 수 있는 통제된 환경을 제공합니다.
용어 풀이
- VLA
- 시각·언어·행동(Vision-Language-Action) 모델. 보고 지시를 이해해 로봇의 동작까지 만들어 내요.
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.