직교 매칭 추적 기반 MoE 모델 전문가 가지치기 기법 소개
OMP-MoE: Efficient Expert Pruning for Mixture-of-Experts LLMs via Orthogonal Matching Pursuit
 arXiv
Mixture-of-Experts(MoE) 모델의 막대한 메모리 문제를 해결하기 위해, 학습 과정 없이 전문가를 효율적으로 제거하는 OMP-MoE 프레임워크가 제시되었습니다.
- 이 방법은 전문가 기여 패턴을 희소 신호 재구성 문제로 변환하고, 직교 매칭 추적(OMP)을 이용해 불필요한 전문가를 선택하여 모델을 압축합니다.
- 실험 결과, 최대 50%의 전문가를 제거해도 원래 성능을 높은 수준으로 유지하며, 검색 및 추론 속도를 대폭 개선하는 효과를 입증했습니다.
- OMP-MoE는 별도의 학습 과정 없이 압축이 가능하다는 강점이 있으나, 최적의 성능을 위해서는 모델 구조 및 하드웨어 환경에 대한 추가 검토가 필요합니다.
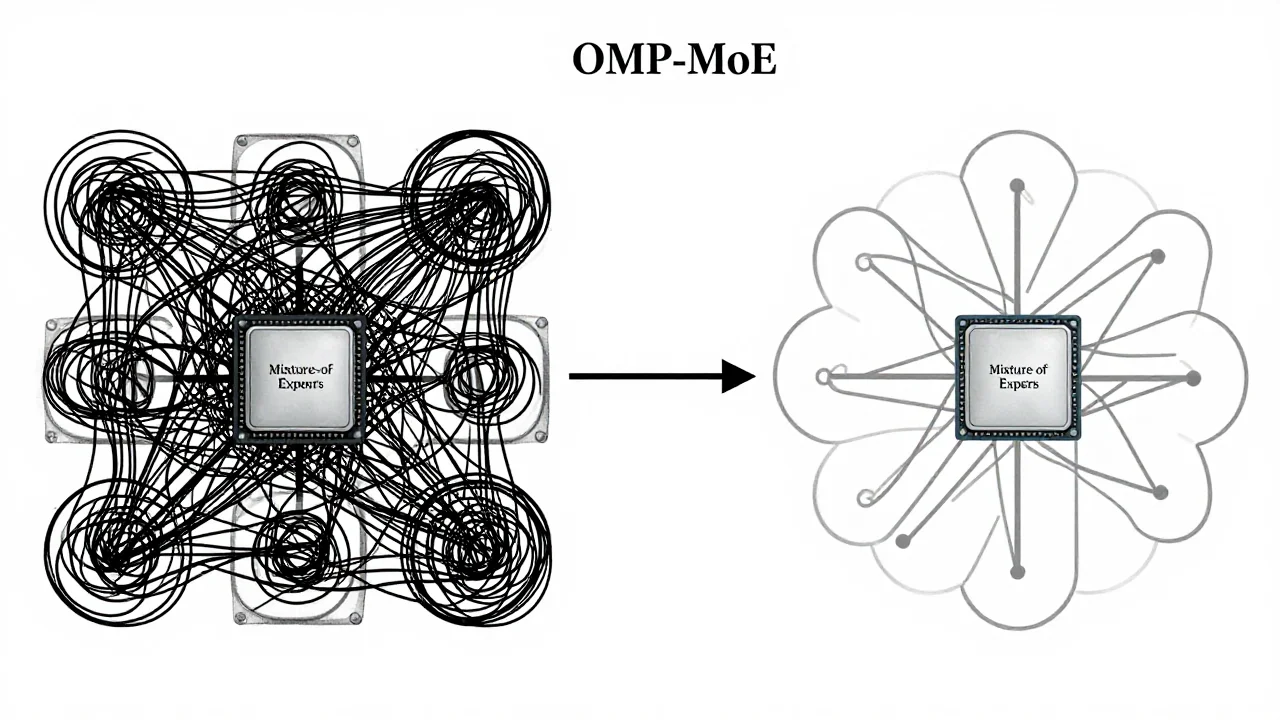
(MoE) 모델은 의 효율적인 확장을 가능하게 하지만, 막대한 메모리 요구 사항이라는 배포상의 어려움을 안고 있습니다. 이러한 문제를 해결하기 위해 OMP-MoE라는 새로운 학습 과정이 필요 없는 압축 프레임워크가 제시되었습니다. 이 방법은 전문가 기여 패턴을 희소 신호 재구성 문제로 재정의하고, 직교 매칭 추적(Orthogonal Matching Pursuit)을 활용하여 MoE 기반 LLM에서 전문가 중복성을 줄이는 방식으로 작동합니다.
OMP-MoE는 먼저 개별 전문가의 기여를 딕셔너리 원자로 간주하며, 선형 계산 복잡도를 가지면서 재구성 오차를 최소화하는 전문가들을 탐욕적으로 선택합니다. 이후에는 재구성 품질과 라우팅 안정성을 모두 고려하여 워터 필링 전략을 통해 레이어 간의 전문가 할당을 최적화합니다. 또한, 에너지 예측에 기반하여 전문가 활성화를 동적으로 조정하는 적응형 추론 메커니즘인 OMP-MoE†도 도입되었습니다.
실험 결과는 Qwen, DeepSeek-V2, GPT-OSS, Mixtral MoE 등 다양한 모델에서 기존 방법 대비 일관된 성능 향상을 보여주었습니다. 특히 25%에서 50%의 가지치기 비율에서도 원래 성능을 높은 수준으로 유지하는 것이 확인되었습니다. 예를 들어, Qwen3-30B-A3B 모델을 50% 압축했을 때도 원래 성능의 93.3%를 유지했으며, 검색 속도는 33배, 추론 속도는 1.55배 향상되는 결과를 달성했습니다.
용어 풀이
- Mixture-of-Experts
- 여러 하위 모델 중 일부만 골라 계산하는 구조. 모델이 커도 실행 비용을 줄일 수 있어요.
- 대규모 언어 모델
- 방대한 글을 학습해 문장을 이해하고 만들어 내는 AI 모델. ChatGPT, Claude, Gemini가 여기에 속해요.