리서치 연구
LLM 에이전트의 장기 뇌파(EEG) 분석 능력 평가를 위한 통합 벤치마크 개발
EEGAgentBench: Benchmarking LLM Agents on Short- and Long-Horizon EEG Analysis
 arXiv
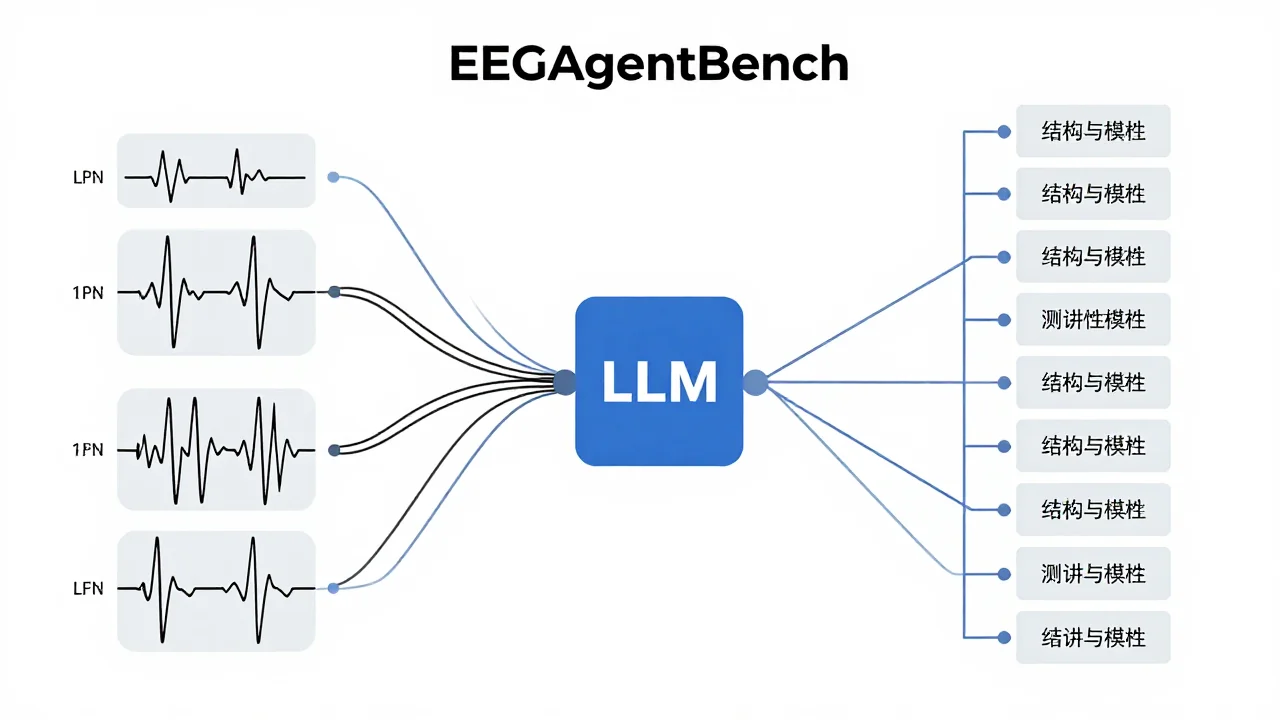
뇌파(EEG) 분석이 단순한 짧은 구간 분류를 넘어 장기적 증거 누적과 복합 추론을 요구함에 따라, LLM 에이전트의 능력을 체계적으로 평가할 통합 벤치마크 'EEGAgentBench'가 개발되었습니다.
세 줄 요약
- 이 벤치마크는 지식 질문 답변부터 수면 단계까지 6가지 응용 분야를 포괄하며, 최대 23시간에 달하는 장기 신호 분석과 다단계 도구 활용 능력을 요구합니다.
- EEGAgentBench는 모델 규모가 아닌, 에이전트의 핵심 역량인 '자율적인 도구 선택', '증거 누적', 그리고 '다단계 워크플로우 구성 능력'을 측정하는 데 중점을 둡니다.
- 평가 결과, 현존하는 LLM 에이전트들은 특히 장시간에 걸친 지속적인 증거 축적과 복잡한 다단계 추론 수행에는 여전히 상당한 기술적 한계를 보였습니다.
뇌파(EEG) 분석이 단순한 짧은 구간 분류를 넘어 장기적 증거 누적과 복합 추론을 요구함에 따라, LLM 에이전트의 능력을 체계적으로 평가할 통합 벤치마크 'EEGAgentBench'가 개발되었습니다.