리서치 연구
PreviewDiff: 확산 모델의 생성을 능동적으로 제어하는 기술
PreviewDiff: Multimodal Critic-Guided Search over Diffusion Latents
 arXiv
확산 모델이 사물 개수나 공간 관계 같은 구성적 디테일을 구현하는 데 어려움을 겪는 문제를 해결하기 위해 'PreviewDiff'라는 새로운 검색 기법을 제안했습니다.
세 줄 요약
- 기존 방식과 달리, 이 방법은 생성 과정 중간 단계에서 다중 모드 비평가의 피드백을 받아 잠재 공간(latent)을 수정하며 최적의 결과로 나아갑니다.
- 본 연구는 AI 콘텐츠에 대한 다중 모드 피드백이 단순히 최종 검증 역할뿐 아니라, 노이즈 제거 과정 자체를 능동적으로 제어하는 핵심 요소임을 입증했습니다.
- 성능 향상을 위해서는 생성 초기에 개입하여 검색 폭을 넓히거나 의미론적 변형을 추가할 때 가장 큰 이점을 얻는 것으로 나타났습니다.
은 이미지를 생성할 때 사물의 개수, 속성 결합, 공간적 관계 등 구성적인 디테일을 정확하게 구현하는 데 어려움을 겪습니다. 기존의 Best-of-N 샘플링 방식은 완료된 결과물 중에서만 선택이 가능하여, 잠재적으로 유망한 경로가 실패하기 전에 수정할 수 없다는 한계가 있었습니다.
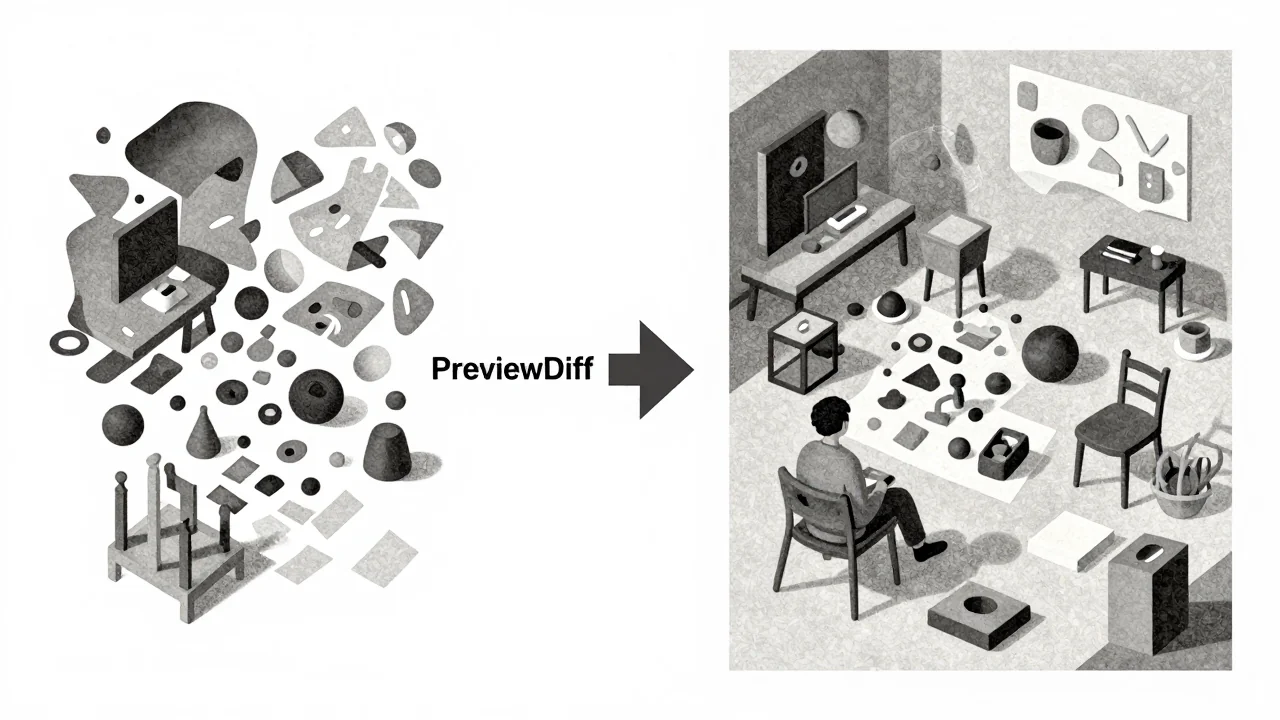
PreviewDiff는 이러한 문제를 해결하기 위해 개발된 학습 과정이 필요 없는 테스트 시간 검색 방법입니다. 이 기법은 확산 샘플링을 스칼라 검색에서 중간 잠재 공간(latent)에 대한 다중 모드 비평가 주도 검색으로 전환합니다. 특정 노이즈 제거 지점(checkpoint)에서 부분적인 미리보기를 디코딩하고, 이를 다중 모드 심사관에게 점수화 및 비평을 요청합니다.
심사관으로부터 받은 자연어 피드백은 시스템이 의미론적 편집과 국소적으로 재노이즈된 잠재 연속 경로를 통해 분기(branch)할 수 있도록 합니다. 이 과정을 통해 생성 과정 중간 단계에서 다중 모드의 피드백을 활용하여 샘플을 수정하고 최적화하는 것이 가능하며, 이는 단순히 최종 검증자 역할뿐 아니라 노이즈 제거 과정 자체를 능동적으로 제어함을 보여줍니다.
용어 풀이
- 확산 모델
- 잡음에서 시작해 조금씩 다듬으며 이미지나 영상을 만들어 내는 생성 모델.
- 프롬프트
- AI에게 주는 지시나 질문 글.