PyO3를 이용한 Rust 성능 통합: Python 라이브러리 구축 가이드
Libraries Run Rust Inside Python (With PyO3)
 Hacker News
PyO3를 활용하여 Rust의 고성능을 Python 환경에 통합하는 방법을 다룹니다. 이를 통해 파이썬 라이브러리 내에서 속도가 중요한 기능을 구현할 수 있습니다.
- 핵심은 데이터 처리 과정 자체가 아니라, Rust 내부의 복잡한 구조(예: JSON 트리)를 Python 객체로 변환하는 '경계면 비용'에 있다는 점입니다.
- 성능 최적화 시 알고리즘 속도보다 Rust와 Python 간의 데이터 교환 경계(Boundary)에 주목해야 합니다. 대규모 데이터를 다룰 때 이 부분이 병목이 됩니다.
- 단순한 스칼라 값 반환은 문제가 적지만, 복합 구조를 처리할 때는 전체 객체를 한 번에 생성하기보다 '지연 평가(Lazy evaluation)' 방식을 도입하는 것이 핵심입니다.
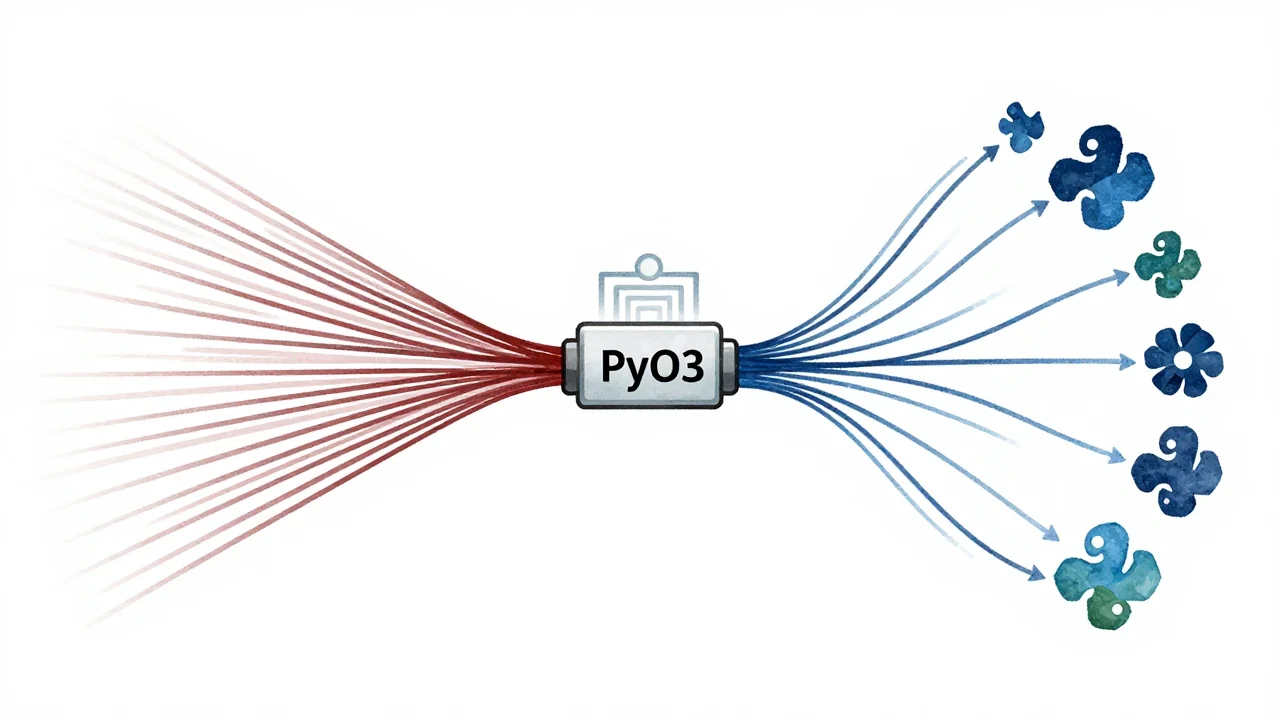
Python 애플리케이션에서 Rust의 고성능을 활용하는 방법은 PyO3와 같은 도구체인을 통해 구현할 수 있습니다. 이 과정은 기본적으로 네 단계로 이루어지는데, 첫째는 일반적인 Rust 모듈 작성, 둘째는 PyO3 매크로를 이용한 주석 처리, 셋째는 Maturin을 사용한 컴파일 및 설치, 마지막으로 Python에서 결과를 임포트하는 순서입니다. 이 과정에서 #[pyfunction]이나 #[pymodule] 같은 속성(attribute macro)은 Rust 함수가 Python 호출을 받고 타입 변환과 참조 카운팅 처리를 할 수 있도록 연결 고리 역할을 합니다.
Rust 코드를 Python에 노출할 때 가장 중요한 성능 병목 지점은 실제 파싱 알고리즘 자체가 아니라, 복잡한 Rust 구조체(예: JSON 트리)를 네이티브 Python 객체로 변환하는 '경계면 비용'입니다. 이 과정에서 .into_pyobject와 같은 트레이트를 구현하여 JsonValue 전체 트리를 순회하며 딕셔너리나 리스트 등의 Python 객체를 재구성해야 합니다. 대규모 문서의 경우, 파싱 자체보다 이러한 자료구조의 메모리화(materialization) 루프가 전체 실행 시간을 지배할 수 있습니다.
따라서 Rust 함수를 포팅할 때 반환 값이 스칼라 값이라면 큰 문제가 없지만, 구조체가 크다면 변환 과정에 대한 최적화가 필수입니다. 가장 효과적인 개선 방안은 전체 트리를 한 번에 Python 객체로 만드는 대신, 지연 평가(lazy evaluation) 방식을 채택하는 것입니다. 즉, 호출자가 모든 노드를 사용하지 않을 경우를 대비하여 Rust 기반의 뷰 형태로 반환하고 필요할 때만 Python 객체를 생성하도록 설계해야 합니다.