리서치 뉴스
특이값 분해(SVD)를 활용한 데이터 근사화 기법
Truncated SVD
 Hacker News
특이값 분해(SVD)를 활용하여 행렬을 분해하고, 가장 중요한 정보만 남기고 나머지 계수를 제거하여 원본 데이터를 근사화하는 기법입니다.
세 줄 요약
- 이 과정은 데이터의 핵심 특징을 유지하면서도, 원래 크기 대비 훨씬 적은 수의 요소만으로 데이터를 재구성할 수 있게 하여 높은 효율성을 제공합니다.
- 단순한 차원 축소를 넘어, 이미지나 텍스처 같은 대용량 데이터 압축 및 저랭크 근사치 계산 등 다양한 실질적 분야에 활용됩니다.
- 이 기술은 데이터의 분산(Variance) 정보가 큰 특이값 순서대로 배열되어 있다는 원리를 이용해, 손실을 최소화하는 핵심 근거를 제공합니다.
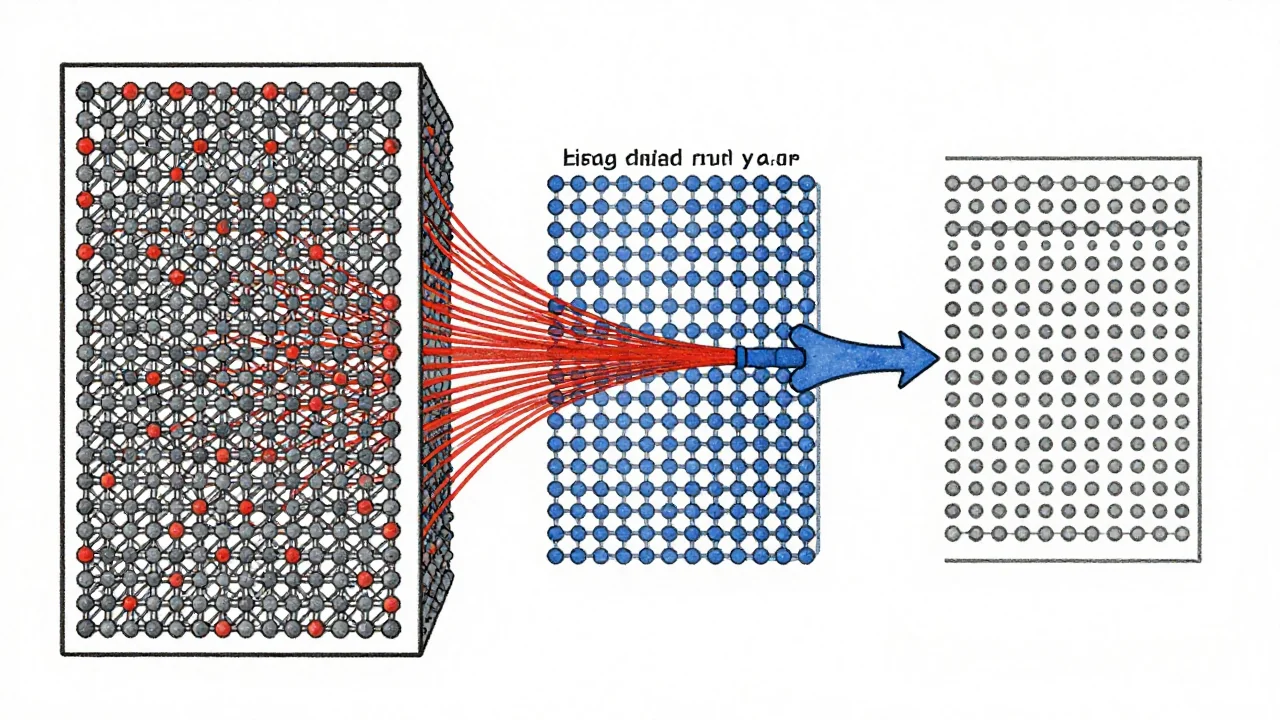
행렬 $M$에 대한 특이값 분해(SVD)는 행렬을 세 개의 행렬 $U$, $\Sigma$, 그리고 $V^T$로 인수분해하는 기술입니다. 이 과정은 데이터 매트릭스 자체를 기반으로 하며, PCA와 유사하지만 차이가 있습니다. 여기서 트렁케이션된 SVD(Truncated SVD)는 $\Sigma$의 계수들 중 가장 상위 $n$개의 값만 남기고 나머지는 0으로 처리하는 행위를 의미합니다.
트렁케이션을 통해 원본 매트릭스 $M'$를 재구성할 때, 원래 정보가 보존되는 특성 덕분에 적은 수의 계수만으로도 원본에 근접한 결과를 얻을 수 있습니다. 실제로 트렁케이션된 행렬들을 사용하여 $M'=U'\Sigma'V'^T$로 재구성하면, 제거하는 계수의 수가 적을수록 $M'$는 $M$에 더 가깝게 근사됩니다.
이 기법은 단순한 차원 축소를 넘어 다양한 실질적인 분야에 활용됩니다. 예를 들어 데이터 압축이나 저랭크 근사치 계산 등에 사용될 수 있습니다. PBR 텍스처 세트의 압축과 같은 응용 사례가 있으며, 이는 데이터의 핵심 특징을 유지하면서도 효율성을 높이는 데 기여합니다.