Dream-RSI: 재귀적 자가 개선 탐색 프레임워크
Dream-RSI: Recursive Self-Improvement through Evolving Worlds
 Hacker News
자율 AI 에이전트의 지속적인 발전을 위해 'Dream-RSI'라는 새로운 탐색 개선 프레임워크가 제안되었습니다. 이 시스템은 복잡한 환경에서 스스로 학습하며 발전하는 순환 구조를 갖습니다.
- 핵심 원리는 과거의 탐색 기록을 활용하여 '리플레이 시뮬레이터'를 구축하는 것입니다. 이를 통해 값비싼 온라인 평가 없이도 저비용으로 정책 개선 피드백을 얻어 효율성을 극대화합니다.
- Dream-RSI는 자율 에이전트가 발견하는 품질은 유지하면서, 탐색 과정에 필요한 비용과 시간을 획기적으로 줄여준다는 점에서 큰 의미를 가집니다.
- 탐색 과정을 명시적이고 프로그래밍 가능하게 만드는 오케스트레이션 계층을 제공하여, 기존 코딩 에이전트 자체를 변경하지 않고도 적용할 수 있습니다.
자율 의 발전에 있어 재귀적 자체 개선(Recursive self-improvement)은 매우 중요해지고 있습니다. 그러나 복잡한 영역에서 높은 가치를 지닌 해답을 발견하는 과정에서 효과적인 탐색 전략 관리가 주요 병목 현상으로 남아있습니다. 기존 시스템들은 고정된 전략으로는 검색 공간이 커짐에 따라 적응하지 못하며, 온라인 정책 최적화는 장기적인 롤아웃 동안 지연되고 비용이 많이 드는 피드백을 처리해야 하는 어려움에 직면합니다.
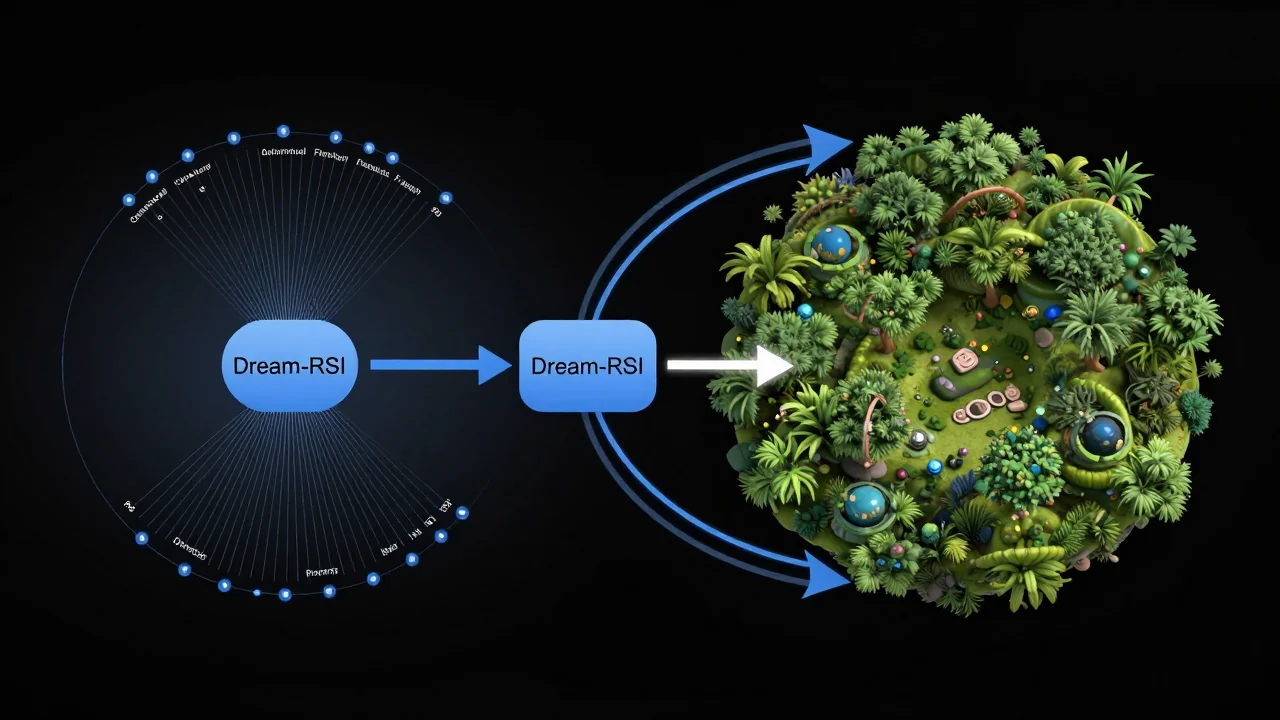
Dream-RSI는 확장 가능하고 재귀적으로 자체 개선되는 탐색 프레임워크를 제시합니다. 이 시스템은 축적된 발견 기록(discovery history)을 활용하여 '리플레이 시뮬레이터'를 구축하는 것이 핵심 원리입니다. 이를 통해 반복적이고 값비싼 온라인 평가를 수행하지 않고도, 저비용의 오프라인 피드백을 확보하여 탐색 정책을 평가하고 개선할 수 있습니다.
개선된 정책은 이후 온라인에 재배치되어 추가적인 발견을 주도하며, 이 과정에서 시뮬레이터 풀이 지속적으로 확장되는 자기 개선 루프를 형성합니다. Dream-RSI는 알고리즘 엔지니어링, 수학적 최적화 등 여러 분야의 설정에서 탐색 비용을 크게 줄이는 동시에 경쟁적이거나 향상된 발견 품질을 달성하는 것으로 보고되었습니다.
용어 풀이
- AI 에이전트
- 목표를 받으면 스스로 계획을 세우고 도구를 써서 여러 단계의 작업을 해내는 AI.