긴 문서 검색을 위한 벡터 청크 분할 기능 도입
Better Vector Search for Long Documents: Chunking Inside Manticore Search
 Hacker News
벡터 검색 시 모델이 긴 문서의 앞부분만 읽고 뒷부분을 놓치는 정보 손실 문제를 해결하기 위해, Manticore Search가 테이블 생성 단계에서 자동 청크 분할 기능을 도입했습니다.
- 복잡한 전처리 과정 없이 테이블 정의에 `chunk_strategy`를 추가하는 것만으로 모든 청크를 임베딩하고 검색할 수 있으며, 실제 테스트에서 재현율(recall)이 크게 향상되었습니다.
- 내부 문서나 방대한 매뉴얼처럼 정보가 분산된 자료를 검색할 때, 중요한 세부 내용까지 놓치지 않고 정확하게 찾아낼 수 있어 활용도가 높아집니다.
- 검색어(Query)는 전체로 임베딩되며 저장된 문서만 분할되지만, 이 기능 사용 시 시스템 메모리 및 데이터 삽입 시간이 증가하는 점을 고려해야 합니다.
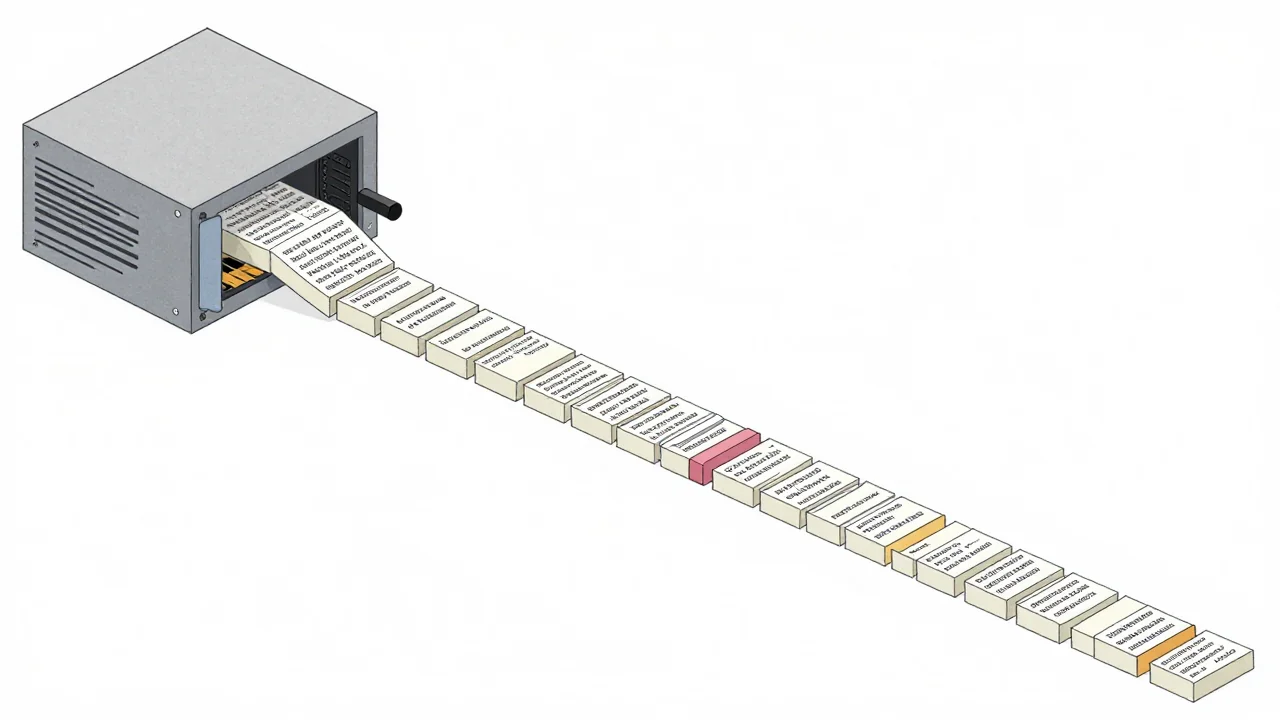
기존의 모델은 긴 문서를 처리할 때 처음 몇 백 개의 만 읽고 나머지 내용은 무시하는 경향이 있습니다. 이로 인해 5,000 토큰에 달하는 문서가 있을 경우, 모델은 앞부분의 내용만을 기반으로 벡터를 생성하며 뒤따르는 중요한 정보는 검색 과정에서 영구적으로 누락될 수 있었습니다.
Manticore Search는 이러한 문제를 해결하기 위해 테이블 정의 단계에서 자동 청크 분할 기능을 제공합니다. 사용자는 벡터 컬럼에 `chunk_strategy`를 추가하고 원하는 전략(예: 'sentence')과 (`max_tokens`, `overlap_tokens`)를 설정하는 것만으로 충분합니다. Manticore는 데이터를 삽입(INSERT)하는 시점에 문서를 자동으로 청크로 분할하고, 각 청크에 대해 임베딩을 생성하며 모든 청크를 검색 대상으로 처리합니다.
이 기능을 통해 문서 깊숙한 곳에 숨겨진 내용의 재현율(recall@5)은 55.1%에서 83.3%로 향상된 것으로 측정되었습니다. 다만, 이 기능은 저장되는 문서를 분할하는 것이지 검색어(Query) 자체를 청크하지는 않습니다. 따라서 쿼리는 전체가 임베딩되며, 시스템 메모리 및 데이터 삽입 시간 증가 등의 고려 사항이 있습니다.
용어 풀이
- 임베딩
- 글이나 이미지의 의미를 숫자 목록으로 바꾼 것. 의미가 비슷한 것을 찾을 때 써요.
- 토큰
- AI 모델이 글을 처리하는 단위. 단어보다 작은 조각이며 사용량과 요금을 셀 때 기준이 돼요.
- 파라미터
- 모델이 학습하면서 조정한 내부 숫자. 개수가 많을수록 대체로 모델이 크고 무거워요.