Qwen 기반 에이전트 모델 NeoHorse-1-4B 공개
TokenRhythm/NeoHorse-1-4B
 Hugging Face
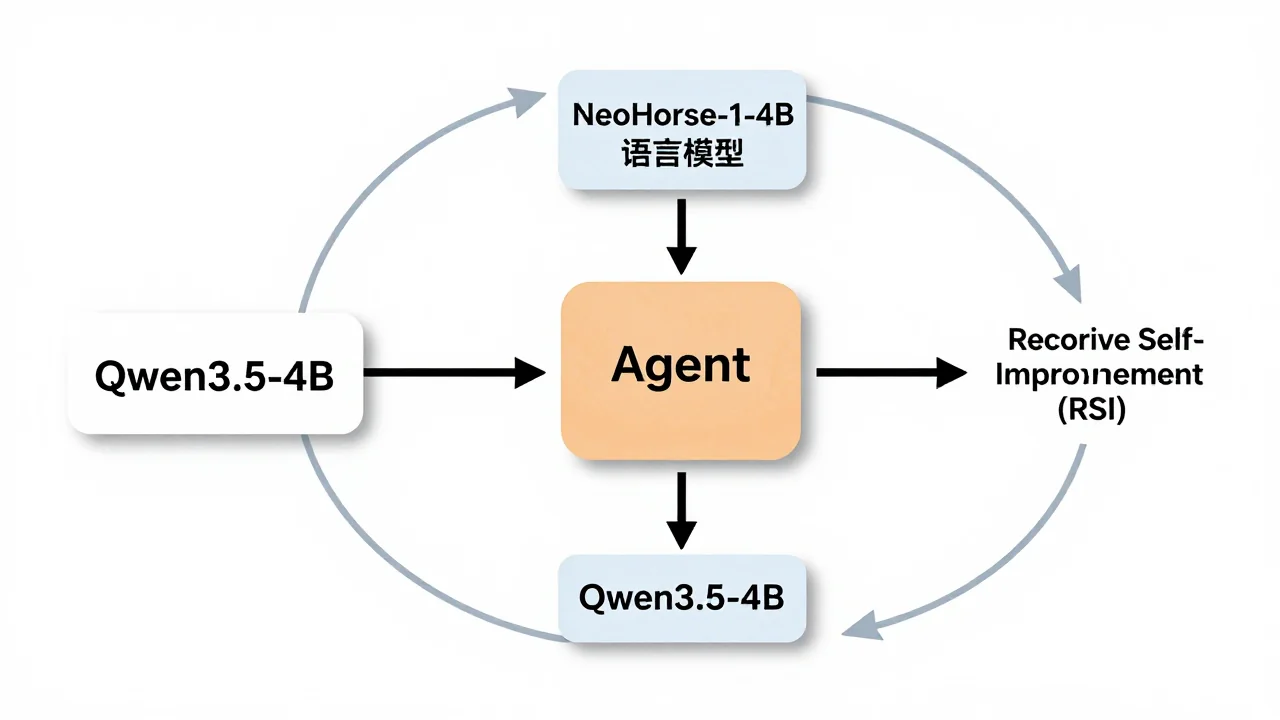
토큰리듬이 Qwen3.5-4B를 기반으로 에이전트 기능을 강화하고 재귀적 자기 개선(RSI)을 목표로 개발한 4B 언어 모델 'NeoHorse-1-4B'가 공개되었습니다.
- 이 모델은 '라우팅 하네스'를 통해 에이전트의 실행 과정을 학습 신호로 활용하여, 기존 대비 벤치마크 평균 점수를 크게 끌어올린 것이 특징입니다.
- 단순 텍스트 생성을 넘어 도구 사용, 코딩, 복합적인 추론 등 고도화된 에이전트 작업을 수행할 수 있어 실무 적용성이 높습니다.
- 주의할 점은 본 모델이 텍스트 추론에 최적화된 언어 모델 가중치만 포함하고 있어, 비전 등 다른 모달리티는 지원하지 않는다는 것입니다.
NeoHorse-1-4B는 Qwen3.5-4B를 기반으로 TokenRhythm에 의해 된 4B 크기의 인과적 언어 모델입니다. 이 모델은 하네스, 도구 사용, 코딩 및 명령어 추종을 위해 후처리(post-training)되었으며, 궁극적으로 재귀적 자기 개선(Recursive Self-Improvement, RSI) 경로를 목표로 합니다. 본 모델은 텍스트 기반의 추론에 최적화된 언어 모델 만 포함하며, 비전과 같은 다른 모달리티는 지원하지 않습니다.
NeoHorse-1-4B는 라우팅 하네스를 통해 에이전트 작업을 수행하는 프레임워크를 갖추고 있습니다. 이 과정에서 도구 상호작용 및 결과를 기록하고, 이를 바탕으로 다음 학습 혼합을 형성합니다. 이러한 에이전틱 후처리 프레임워크는 라우팅 기반 커리큘럼 SFT와 온-정책 증류(on-policy )를 탐구하여 실행 궤적 자체를 학습 신호로 활용하는 것이 특징입니다.
평가 결과에 따르면, NeoHorse-1-4B는 여러 에서 성능 향상을 보였습니다. 예를 들어, 10개 벤치마크의 거시 평균(macro average) 점수는 Qwen3.5-4B 대비 +5.93점 증가한 64.87을 기록했습니다. 또한, 에이전트 관련 벤치마크인 WorkBuddy Bench에서는 34.41점을 달성하며 기존 모델보다 높은 성능을 보였습니다.
용어 풀이
- 파인튜닝
- 이미 학습된 모델을 특정 목적의 데이터로 조금 더 학습시키는 일.
- 에이전트
- 목표를 받으면 스스로 계획을 세우고 도구를 써서 여러 단계의 작업을 해내는 AI.
- 가중치
- 학습으로 정해진 모델 내부의 숫자 값. 내려받는 모델 파일의 본체예요.
- distillation
- 큰 모델의 답을 작은 모델이 따라 배우게 해서 가볍고 빠른 모델을 만드는 방법.
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.