모델 도구
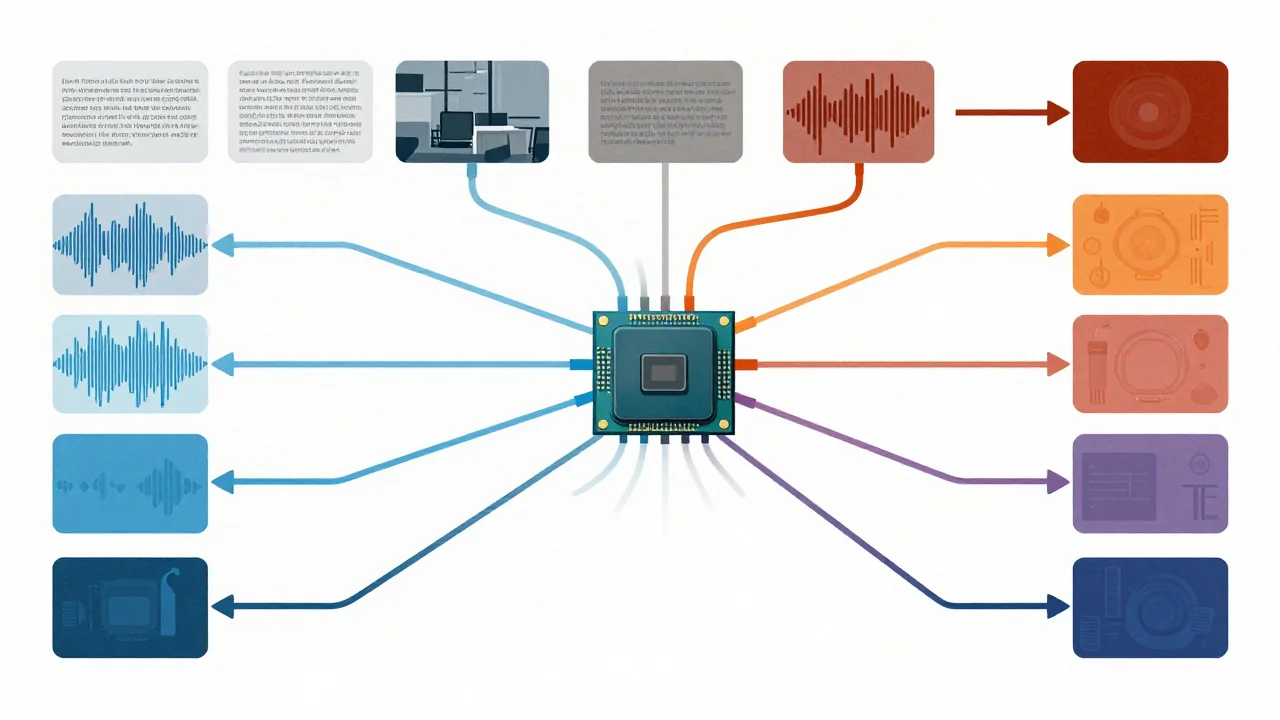
Gemma 4 기반 다중 모드 의사 결정 분류기 Jev-Omni 소개
akhilaaa3/Jev-Omni
 Hugging Face
Jev-Omni는 텍스트, 이미지, 오디오, 비디오 등 다양한 모달리티를 입력받아 질문에 대한 선택지별 확률 분포를 계산하는 다중 모드 의사 결정 분류기입니다.
세 줄 요약
- Gemma 4 12B IT 기반으로 개발되었으며, DecisionBench 등 여러 벤치마크에서 높은 정확도를 입증하며 강력한 성능을 보여주었습니다.
- 단순히 설명을 생성하는 것이 아니라 각 선택지에 대한 정량적 확률을 제공하므로, 구조화된 의사 결정이나 분류가 필요한 시스템에 최적화되어 있습니다.
- 최대 20개 이하의 옵션에서 최고의 성능을 기대할 수 있으며, 원활한 구동을 위해서는 CUDA GPU와 같은 고성능 하드웨어 환경이 필요합니다.
Jev-Omni는 Gemma 4 12B IT를 기반으로 구축된 다중 모드() 의사 결정 분류기입니다. 이 모델은 텍스트, 이미지, 오디오, 비디오 등 다양한 형태의 입력을 처리할 수 있으며, 사용자가 제시한 질문과 선택지 옵션에 대해 생성 설명 대신 각 옵션별 확률 분포를 제공하는 것이 특징입니다.
다양한 테스트에서 높은 성능을 보여주었습니다. DecisionBench Medium에서는 87.57%의 정확도를 기록했으며, JevBench에서도 86.15%의 정확도를 달성했습니다. 또한, 오디오 입력은 최대 30초까지, 비디오는 16프레임까지 처리할 수 있도록 설계되었습니다.
이 모델을 사용하기 위해서는 가 필요하며, 추론 시 BF16 autocast를 사용하는 것이 권장됩니다. 성능 면에서는 옵션 개수가 20개 이하일 때 가장 좋은 지원을 받을 수 있습니다. 개발자는 `pip install` 명령어를 통해 라이브러리를 설치하고 Python 코드를 이용해 예측(predict) 기능을 활용할 수 있습니다.
용어 풀이
- multimodal
- 글뿐 아니라 이미지·음성·영상처럼 여러 형태의 입력을 함께 다루는 것.
- 벤치마크
- 모델 성능을 같은 조건에서 비교하려고 만든 시험 문제 모음.
- CUDA
- 엔비디아 GPU에서 계산 프로그램을 돌리게 해 주는 개발 플랫폼.
- GPU
- 많은 계산을 한꺼번에 처리하는 칩. AI 학습과 실행에 가장 많이 써요.